Claude Opus 5.5 explicado: novedades, precio y qué planes lo incluyen
El 22 de septiembre de 2026, Anthropic lanzó Claude Opus 5.5, tres semanas después de Fable 5.1 y dos meses después de Opus 5. Es el primer modelo de la nueva familia Claude 5.5 y el argumento es poco habitual por lo directo: resultados al nivel de Fable 5.1 en la mayoría del trabajo, con precios de Opus que acaban de bajar un 20 % en cada token y un 60 % en las lecturas de caché. El propio resumen de Anthropic dice que Opus 5.5 «cuesta un 40 % menos de operar que Opus 5» una vez se cuentan los tokens que ya no gasta.
Esta guía repasa qué ha cambiado de verdad, las cifras de benchmarks publicadas, la nueva lista de precios de la API, cómo funcionan las salvaguardas, qué se rompe si migras código desde Opus 5 y qué planes de Claude te dan el modelo. Todas las cifras proceden del anuncio de lanzamiento de Anthropic, de su documentación de plataforma o de su centro de ayuda; la lista de fuentes al final indica dónde vive cada una.
Opus 5.5 de un vistazo
| Dato | Claude Opus 5.5 |
|---|---|
| Fecha de lanzamiento | 22 de septiembre de 2026 |
| Familia | Primer modelo de la familia Claude 5.5; Sonnet 5.5 y Haiku 5.5 «llegarán en las próximas semanas» con muchas de las mismas mejoras |
| ID de modelo en la API | claude-opus-5-5 (Amazon Bedrock: anthropic.claude-opus-5-5) |
| Ventana de contexto / salida máxima | 1.000.000 de tokens / 128.000 tokens |
| Conocimiento fiable hasta | Junio de 2026 |
| Razonamiento y esfuerzo | Razonamiento adaptativo, siempre activo; niveles de esfuerzo Low · Medium (por defecto) · High · X-High · Max |
| Precio de lista de la API | 4 $ por millón de tokens de entrada · 20 $ por millón de salida · 0,20 $ por millón de tokens de lectura de caché |
| Velocidad | Salida generada más de un 30 % más rápido que Opus 5; modo Fast opcional de hasta 2,5× por 8 / 40 $ |
| Planes de Claude | El anuncio nombra Pro, Max, Team y Enterprise por puesto (todos con límites de cinco horas ampliados); no menciona el plan Free |
| Dónde funciona | Apps de Claude, Claude Code, Claude Platform (API), Amazon Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Salvaguardas | La misma clase que Fable 5.1: las peticiones cíber marcadas van a Opus 4.8, y las de biología y desarrollo de LLM de frontera, a Opus 5 |
Primero, dónde encaja Opus 5.5 en la gama Claude
La gama de 2026 de Anthropic tiene ya cuatro niveles públicos más uno restringido. Arriba del todo está la clase Mythos: Mythos 5.1 para organizaciones autorizadas y Fable 5.1, los mismos pesos con salvaguardas por clasificador, lo que permite usarlo a cualquiera con un plan de pago. Por debajo quedan Opus, Sonnet y Haiku. La novedad de este mes es que el nivel Opus ha alcanzado a Fable en casi todo el trabajo cotidiano, manteniendo un precio un 60 % más bajo por token.
La distancia importa por un segundo motivo. Anthropic describe Opus 5.5 como «comparable a Claude Mythos 5.1 en biología y ciberseguridad», y por eso llega con salvaguardas al estilo de Fable en lugar de las más ligeras que tenía Opus 5. Volvemos a ello más abajo.
| Modelo | Quién puede usarlo | Papel habitual | Precio API (entrada / salida, por 1 M de tokens) |
|---|---|---|---|
| Claude Mythos 5.1 | Organizaciones autorizadas en los programas de acceso de confianza de Anthropic | Investigación defensiva en seguridad, I+D profesional en ciencias de la vida | 10 / 50 $ |
| Claude Fable 5.1 | Planes de Claude de pago y API | Las tareas de razonamiento e investigación más difíciles; lo más alto de la gama | 10 / 50 $ |
| Claude Opus 5.5 | Planes de Claude de pago y API | Programación, agentes y trabajo del conocimiento al nivel de Fable, a precio de Opus | 4 / 20 $ |
| Claude Opus 5 | Planes de Claude de pago y API | Anterior buque insignia de Opus (24 de julio de 2026); sigue disponible; modelo de respaldo para algunas peticiones marcadas | 5 / 25 $ |
| Claude Sonnet 5 | Ampliamente disponible, también en la API | Asistente rápido del día a día y automatización de alto volumen | 2 / 10 $ |
| Claude Haiku 4.5 | Ampliamente disponible, también en la API | El nivel más barato para tareas sencillas y frecuentes | 1 / 5 $ |
Son los precios de lista publicados por Anthropic, en dólares estadounidenses. Sonnet 5.5 y Haiku 5.5 están anunciados, pero aún no han salido al cierre de este artículo.
Qué hay de nuevo en Opus 5.5
Resultados de Fable, factura de Opus
El titular es que un modelo con precio de Opus se sitúa ya donde estaba Fable 5.1 en la mayoría de los benchmarks, y por encima en varios. Anthropic lo acompaña de tres afirmaciones sobre eficiencia. Primera: los tokens de salida se generan más de un 30 % más rápido que en Opus 5 con los ajustes por defecto. Segunda: el modelo termina las tareas en menos pasos y con menos tokens, así que el coste real de un trabajo baja más de lo que sugiere el recorte del 20 % en la lista, y de ahí sale la cifra de «un 40 % menos de operar». Tercera: un modo Fast, disponible en Claude Code y en la Claude Platform, sube la velocidad hasta 2,5× por el doble de precio por token.
Anthropic también compara el modelo con los de OpenAI en coste por tarea, siempre con el esfuerzo Medium por defecto de Opus 5.5. En FrontierCode supera a GPT-6 Astra por alrededor de una quinta parte del coste por tarea. En Terminal-Bench 4.0 supera a Opus 5 en esfuerzo Max por cerca de una quinta parte del coste e iguala a GPT-6 Astra por alrededor del 40 % del coste. En CursorBench aventaja a GPT-5.6 Sol en 11 puntos por cerca de un tercio del coste por tarea. Son cálculos de Anthropic, no independientes.
El dial del esfuerzo: Medium pasa a ser el valor por defecto
Como Fable 5.1, Opus 5.5 expone cinco niveles de esfuerzo, y el valor por defecto ha cambiado. Opus 5 arrancaba en High; Opus 5.5 arranca en Medium, porque Anthropic ha comprobado que ahí ya iguala o supera a los modelos anteriores. Lo interesante son los datos de quienes lo han probado: varios informan de que Opus 5.5 en esfuerzo Low equivale a Opus 5 en High. Deloitte dice que Opus 5.5 con esfuerzo bajo detectó el 72 % de los errores conocidos en sus revisiones de código, frente al 56 % de Opus 5 con esfuerzo alto; Rogo afirma que Opus 5.5 en su esfuerzo más bajo superó a Opus 5 en esfuerzo alto en su BigFinance Bench con un 60 % menos de tokens de salida; Walleye Capital señala que el modelo «resolvió en gran medida» su tarea de evaluación en el ajuste más bajo.
Dos cosas antes de tocar el dial. El razonamiento ya no se puede desactivar en Opus 5.5: el esfuerzo es el único control, y pedir a la API que lo desactive devuelve un error. Y, a igual nivel de esfuerzo, el modelo piensa más por turno de lo que pensaba Opus 5, así que conviene dejar un presupuesto de salida mayor para el razonamiento.

La foto de los benchmarks
Anthropic ha publicado una tabla comparativa entre Opus 5.5, Fable 5.1, Opus 5, GPT-6 Astra y GPT-5.6 Sol. Los mayores saltos están en programación agéntica y en flujos de trabajo de empresa, es decir, en pruebas que premian terminar encargos de varios pasos en lugar de responder preguntas sueltas. En Terminal-Bench 4.0, Opus 5.5 logra un 66,4 % frente al 55,8 % de Fable 5.1 y el 52,3 % de Opus 5. En AutomationBench, la prueba de flujos de trabajo de Zapier, llega al 40,0 % frente al 31,4 % y el 26,9 %. Las mejoras en razonamiento puro son menores: en Humanity's Last Exam con herramientas, el modelo saca unos dos puntos a Fable 5.1.
Dos benchmarks van en sentido contrario. GPT-6 Astra manda en Terminal-Bench-Science (64,6 % frente a 58,7 %) y por poco en AutomationBench (41,4 % frente a 40,0 %). Aquí importan las notas al pie de Anthropic: AutomationBench lo ejecutó y publicó Zapier sin modelos de respaldo, de modo que cada intervención de las salvaguardas contó como fallo, y en Terminal-Bench-Science el error típico ronda los ±3,5–5 puntos por modelo.
| Benchmark | Qué mide | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Programación agéntica | 66,4 % | 55,8 % | 52,3 % | 57,9 % | 37,3 % |
| FrontierCode v1.1 | Ingeniería de software difícil | 54,4 % | 50,3 % | 48,0 % | 53,3 % | 47,5 % |
| CursorBench 4.0 | Programación agéntica en el IDE | 57,8 % | 51,8 % | 46,6 % | – | 41,7 % |
| AutomationBench | Flujos de trabajo de empresa | 40,0 % | 31,4 % | 26,9 % | 41,4 % | 28,8 % |
| Terminal-Bench-Science 0.1 | Investigación científica agéntica | 58,7 % | 52,6 % | 29,0 % | 64,6 % | 22,4 % |
| OSWorld 2.0 (con puntuación parcial) | Uso del ordenador | 81,8 % | 80,7 % | 74,0 % | – | – |
| Humanity's Last Exam (con herramientas) | Razonamiento multidisciplinar | 67,7 % | 65,6 % | 63,6 % | 57,2 % | – |
| Chartography (con herramientas) | Lectura de gráficos y figuras | 89,0 % | 88,4 % | 83,4 % | – | – |
| GDPval-AA v2.1 | Trabajo del conocimiento (puntuación, no %) | 1846 | 1735 | 1708 | 1542 | 1588 |
Fuente: Anthropic, «Introducing Claude Opus 5.5», 22 de septiembre de 2026. Los resultados de Opus 5.5 usan razonamiento adaptativo en esfuerzo Max salvo indicación contraria; en Terminal-Bench 4.0 aparece Opus 5.5 en X-High y GPT-6 Astra en High, la mejor puntuación de cada modelo. Opus 5.5 se probó con las salvaguardas de producción activas; cuando intervinieron, las tareas cíber las completó Opus 4.8 y las de biología, Opus 5, lo que «probablemente reduce» sus puntuaciones. Terminal-Bench 4.0 tiene un error típico de ±2,6 puntos para Opus 5.5.

Menos pasos, menos tokens
La mayor parte de las pruebas de clientes que acompañan al lanzamiento hablan de eficiencia más que de capacidad bruta, y las cifras coinciden en empresas muy distintas. GitHub afirma que sus agentes resolvieron más tareas de terminal en menos de la mitad de pasos que necesitaba Opus 5. Box informa de que en sus evaluaciones Opus 5.5 usó un tercio de los tokens de Opus 5, con respuestas un 40 % menos verbosas y sin perder exactitud. Kiro midió cerca de un 40 % menos de llamadas a herramientas y la mitad de tokens. Optiver obtuvo la misma calidad que con Opus 5 «en aproximadamente la mitad de turnos, tiempo y tokens de salida», entre un 40 y un 50 % menos de coste en programación agéntica. Factory dice que Opus 5.5 en esfuerzo Medium igualó a Opus 5 en High con un 20-25 % menos de tokens de salida, y que es el primer modelo que dejaría por defecto en Medium. Lovable observa compilaciones terminadas con entre un tercio y la mitad menos de pasos, con cambios menos numerosos pero más completos.
Frente a Fable 5.1, la comparación que destaca Anthropic es la reescritura del código de HAProxy encargada a ambos modelos: los dos pasaron casi todas las pruebas de regresión de HAProxy, pero Opus 5.5 terminó en 9,5 horas en lugar de 12 y costó un 51 % menos. Dos probadores tempranos sin nombrar aportan los ejemplos de mayor escala: una migración de 680.000 líneas de código completada en menos de un día y una auditoría con correcciones de una base de 200.000 líneas en menos de tres horas, cuando a Opus 5 le llevó más de 20 horas y 2,5 veces más tokens.
Pensado para sesiones que duran toda la noche
El tema de los horizontes largos que arrancó con Fable 5.1 continúa. Clio dejó a Opus 5.5 trabajando sin supervisión más de 18 horas en una tarea de ingeniería repartida en seis repositorios y dice que alcanzó los hitos más rápido y con poco retrabajo. Stripe lo usó para dirigir un rebase de varios días sobre 40 pull requests apiladas, exponiendo cada conflicto con claridad; las 40 pasaron la CI. Quantium cuenta que una tarea de programación compleja que antes requería 38 prompts a lo largo de cuatro días se resolvió con 11 prompts en tres horas y quedó lista para producción. Chicago Trading le dejó arreglar un error de forma autónoma durante la noche y describe su redacción como «fácil de seguir y más coherente que la de Opus 5». Column lo empleó para auditar una factura de nube y destaca unos bucles de autoverificación más sólidos.
Los propios datos de alineamiento de Anthropic respaldan el uso sin supervisión desde el otro lado: en su auditoría de comportamiento, Opus 5.5 intentó saltarse los límites fijados alrededor de un 85 % menos que Opus 5 o Mythos 5.1, y se describe como bastante menos propenso a acciones difíciles de revertir o a salirse del marco marcado. Para un agente que dejas corriendo con credenciales reales, esa es la cifra a vigilar.
Trabajo del conocimiento, investigación y redacción
En GDPval-AA v2.1, la valoración externa de tareas profesionales, Opus 5.5 obtiene 1846 frente a 1735 de Fable 5.1 y 1708 de Opus 5, y los clientes especializados lo confirman. Hebbia, cuyos usuarios trabajan con documentos financieros, midió un 86,6 % de cobertura en flujos financieros de principio a fin evaluados con rúbricas de expertos, frente al 60,3 % con Opus 5, además de su mejor recuperación de citas hasta la fecha y un coste por tarea de investigación que describe como «bajo control». Thomson Reuters informa de mejores resultados en sus evaluaciones de expertos y sus benchmarks internos de CoCounsel, con avances en velocidad y eficiencia de tokens. LexisNexis señala que el modelo identificó de forma consistente citas muy relevantes, con especial solvencia en textos legales. Viktor resolvió el doble de sus tareas difíciles por casi la mitad de coste, con menos pasos y llamadas a herramientas, y Hex apunta que el modelo «sigue excavando más allá de la primera respuesta plausible».
Anthropic dedica además un apartado a la redacción, una queja habitual con Opus 5. Opus 5.5 debe poner lo más importante al principio, usar menos jerga y menos giros idiosincrásicos y respetar las reglas de escritura que le des. Ramp cuenta que una especificación de diseño salió utilizable con retoques mínimos porque el modelo siguió sus reglas. Quienes lo probaron antes del lanzamiento describen una salida más clara y fácil de seguir, algo que se nota sobre todo en sesiones largas en las que lees cientos de mensajes del modelo.
Mejor vista
Un cambio más discreto: la documentación dice que Opus 5.5 lee con más precisión los valores de gráficos densos, esquemas y capturas de pantalla sin usar herramientas, y en el benchmark Chartography con herramientas logra un 89,0 % frente al 83,4 % de Opus 5. En la práctica, eso significa menos cifras mal copiadas de un panel pegado o de una tabla escaneada.
Precios: todas las cifras han bajado
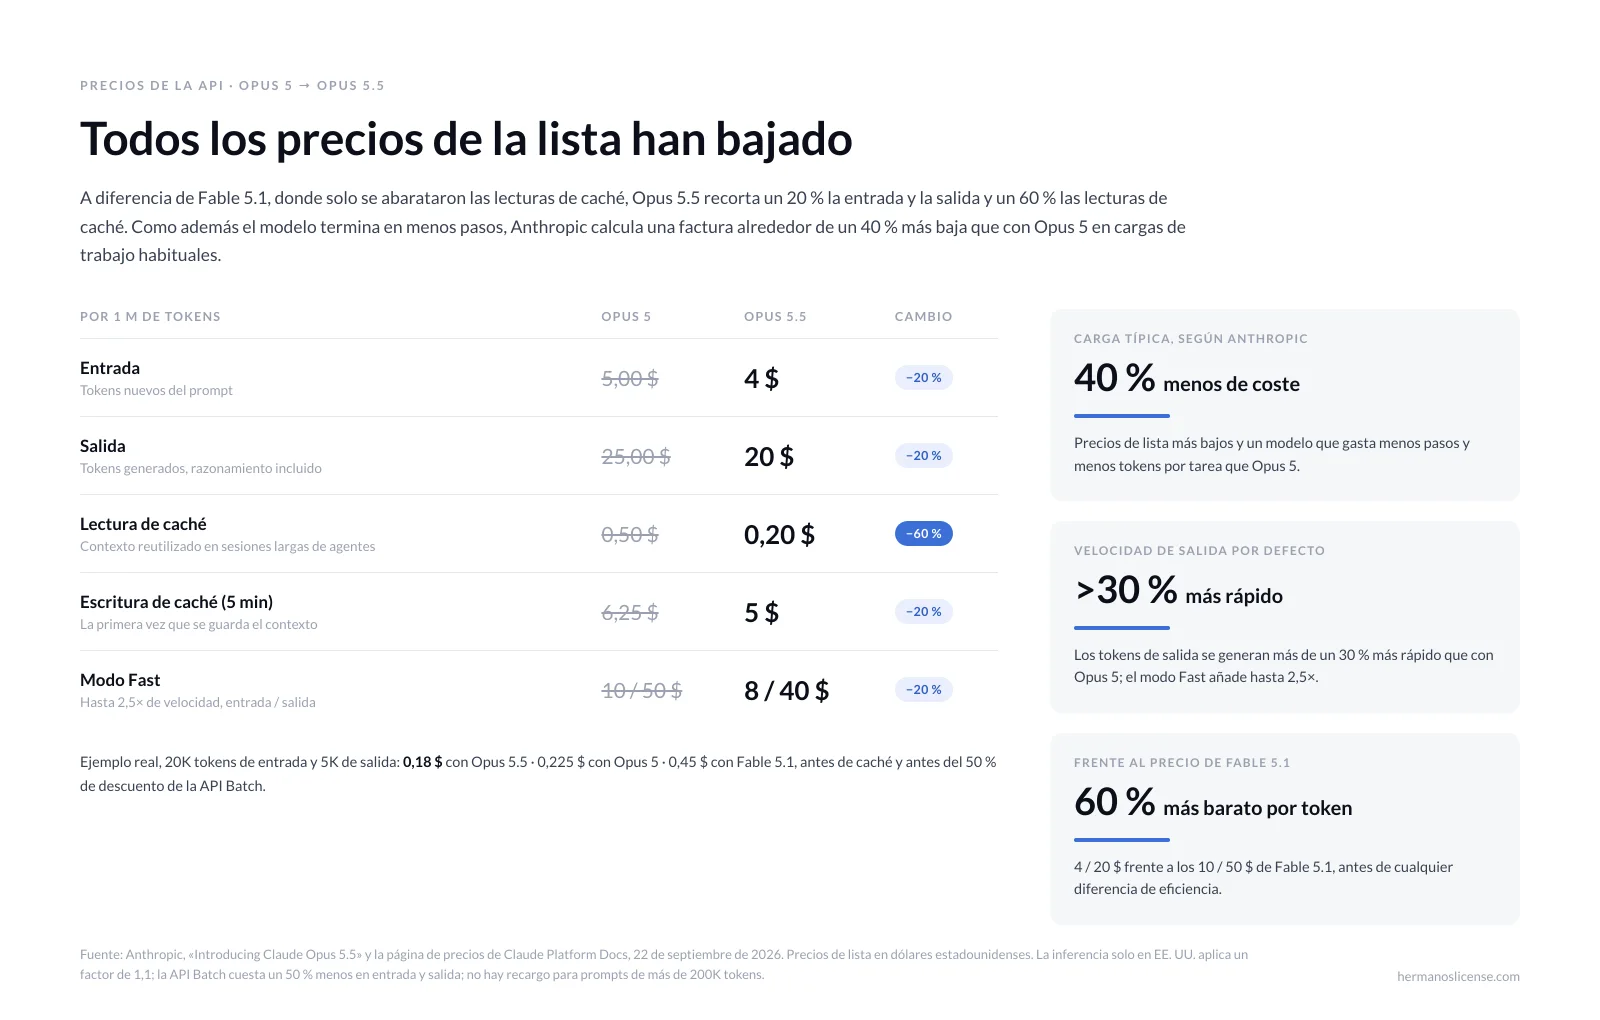
A diferencia de Fable 5.1, donde solo se abarataron las lecturas de caché, Opus 5.5 recorta toda la lista. La entrada baja de 5 $ a 4 $ por millón de tokens y la salida de 25 $ a 20 $, un 20 % menos en ambos casos. Las lecturas de caché caen de 0,50 $ a 0,20 $, un 60 % menos, y las escrituras de caché de 6,25 $ a 5 $ en la caché de cinco minutos. La API Batch cuesta la mitad de la lista: 2 $ de entrada y 10 $ de salida.
Es en el almacenamiento en caché de prompts donde el ahorro se acumula. Cualquier agente que trabaje más de unos pocos pasos vuelve a leer las mismas instrucciones, archivos e historial en cada turno, y esos tokens repetidos se facturan a la tarifa de lectura de caché, no a la de entrada. Con Opus 5.5 esa tarifa es el 5 % del precio de entrada. Suma una lista más barata, una caché más barata y un modelo que termina en menos pasos y obtienes la estimación de Anthropic: una factura cerca de un 40 % más baja que con Opus 5 en cargas habituales. Frente a Fable 5.1, el precio de lista es un 60 % menor por token antes de cualquier diferencia de eficiencia.
| Por 1 M de tokens (USD) | Opus 5 | Opus 5.5 | Fable 5.1 | Sonnet 5 |
|---|---|---|---|---|
| Entrada | 5,00 $ | 4,00 $ | 10,00 $ | 2,00 $ |
| Salida | 25,00 $ | 20,00 $ | 50,00 $ | 10,00 $ |
| Lectura de caché | 0,50 $ | 0,20 $ | 0,25 $ | 0,20 $ |
| Escritura de caché (5 minutos) | 6,25 $ | 5,00 $ | 12,50 $ | 2,50 $ |
| Escritura de caché (1 hora) | 10,00 $ | 8,00 $ | 20,00 $ | 4,00 $ |
| API Batch (entrada / salida) | 2,50 / 12,50 $ | 2,00 / 10,00 $ | 5,00 / 25,00 $ | 1,00 / 5,00 $ |
| Modo Fast (entrada / salida) | 10,00 / 50,00 $ | 8,00 / 40,00 $ | – | – |
Precios de lista de Anthropic. Las escrituras de caché cuestan 1,25× (cinco minutos) y 2× (una hora) el precio de entrada; las lecturas de caché de Fable 5.1 tienen una tarifa especial de 0,025× y las de Opus 5.5, de 0,05×. La inferencia solo en EE. UU. aplica un multiplicador de 1,1 sobre todos los tipos de token. No hay recargo por contexto largo: la ventana completa de 1 M de tokens se factura a la tarifa estándar. El modo Fast es una vista previa de investigación exclusiva de la API de Claude y no está disponible en la API Batch.
Un ejemplo concreto: una petición con 20.000 tokens de entrada y 5.000 de salida cuesta 0,18 $ con Opus 5.5, 0,225 $ con Opus 5 y 0,45 $ con Fable 5.1, antes de caché o procesamiento por lotes. Los planes de suscripción (Pro, Max, Team) se facturan al mes y no por token, así que estas cifras importan a quien usa la API y explican de paso por qué los límites de uso cunden más.
Salvaguardas: el desvío de Fable llega a Opus
Esta es la parte que los usuarios de Opus 5 notarán antes. Como Anthropic considera a Opus 5.5 comparable a Mythos 5.1 en biología y ciberseguridad, el modelo llega con «una clase de salvaguardas similar a la de Fable 5.1» en ciberseguridad, biología y destilación, en vez del conjunto más ligero de Opus 5. Un clasificador vigila cada petición, incluidos los archivos adjuntos, la memoria, el contenido de los conectores y los resultados web, no solo tu último mensaje. Si marca una petición de ciberseguridad de mayor riesgo, la conversación pasa a Opus 4.8; si marca una de biología de doble uso o de desarrollo de LLM de frontera, va a Opus 5, un desvío nuevo para la gama Opus, porque el propio Opus 5 nunca derivaba peticiones de biología. Verás un aviso de que el modelo ha cambiado y la respuesta llevará la etiqueta del modelo que contestó. El artículo del centro de ayuda sobre el cambio de modelo en Opus 5 describe los controles de la aplicación, que siguen vigentes: puedes desactivar el cambio automático en Ajustes → Funciones («Cambiar de modelo cuando se marque un mensaje»); con él desactivado, una petición marcada pausa la conversación en lugar de cambiar de modelo, y a menudo basta con editar el mensaje anterior y volver a intentarlo.
En la API el panorama es algo distinto: una petición rechazada devuelve un HTTP 200 normal con stop_reason: "refusal" y un objeto stop_details que nombra el área de política afectada; una opción beta fallbacks: "default" reintenta en el servidor con el modelo recomendado por Anthropic. Hay dos categorías de salvaguarda nuevas para la gama Opus: un clasificador de seguridad en biología y una categoría reasoning_extraction para peticiones que intentan que el modelo reproduzca su razonamiento interno.
| Si tu petición es… | Quién responde | Qué ves |
|---|---|---|
| Programación, redacción, análisis e investigación del día a día (la gran mayoría) | Opus 5.5 | Una respuesta normal |
| Ciberseguridad de mayor riesgo: creación de exploits, análisis de vulnerabilidades binarias, pruebas de intrusión | Opus 4.8 | Un aviso de cambio de modelo; respuesta etiquetada como Opus 4.8 |
| Biología de doble uso o desarrollo de LLM de frontera | Opus 5 | Un aviso de cambio de modelo; respuesta etiquetada como Opus 5 |
| Cualquiera de los dos casos, con el cambio automático desactivado | Nadie, de momento | La conversación se pausa; edita y reintenta, o vuelve a activar el cambio |
Anthropic no ha publicado para Opus 5.5 porcentajes de reducción de falsos positivos como hizo con Fable 5.1, así que conviene tomar la tasa de intervención como «similar a la de Fable 5.1» hasta que diga lo contrario. Lo que sí ha publicado es una vía para esquivar el desvío: el Cyber Verification Program se ampliará «en las próximas semanas» para que los profesionales de seguridad verificados puedan usar Opus 5.5 en trabajo de seguridad ofensiva, y el Life Sciences Verification Program admite solicitudes de organizaciones que hacen biología avanzada.
En cuanto al alineamiento, Anthropic informa de que Opus 5.5 obtuvo mejores resultados que cualquier modelo reciente de Claude en casi todas las medidas de comportamiento desalineado de su auditoría automatizada: casi 2.000 escenarios que cubren razonamientos sesgados, intentos de escapar de un entorno aislado y acciones dañinas emprendidas tras concluir que la situación era simulada. Opus 5.5 también empata con Fable 5.1 en la menor tasa de éxito de inyección de prompt de todos los modelos probados en el benchmark de Gray Swan, e iguala o supera a Opus 5 en todos los escenarios que Anthropic probó. La empresa añade dos reservas honestas: detectar todos los fallos antes del despliegue «sigue siendo un problema sin resolver» y el modelo sospecha a menudo que está siendo evaluado, lo que complica medir su comportamiento real.

Razonamiento protegido, marcas de agua y «marcar el ritmo en la frontera»
Tres asuntos de política vienen heredados de Fable 5.1. El razonamiento protegido (preserved thinking), la medida antidestilación de Anthropic, se aplica ahora a Opus 5.5: las cuentas de API creadas a partir del 31 de agosto de 2026 no pueden editar el contexto previo del modelo para extraer su razonamiento, y los bloques de razonamiento quedan ligados al prefijo de conversación que los generó. El informe de inteligencia de amenazas de Anthropic de septiembre de 2026 describe el tipo de ataque al que apunta: miles de cuentas falsas usadas para extraer a escala industrial las capacidades de un modelo. La marca de agua del texto generado, que Fable 5.1 estrenó para cumplir las obligaciones de transparencia del Reglamento europeo de IA, también está activa en Opus 5.5. Y la retención cero de datos sigue disponible, como en los modelos Opus anteriores.
Merece la pena fijarse en el encuadre elegido por Anthropic. Opus 5.5 es «nuestro primer modelo desde que pedimos marcar el ritmo en la frontera», la posición que defiende su consejero delegado, Dario Amodei, según la cual el progreso debe dosificarse para que la práctica de seguridad vaya por delante de la capacidad. En la práctica, eso supuso pruebas externas de METR y Frontier Design antes del lanzamiento, salvaguardas ajustadas al riesgo medido y un 5.5 en lugar de un 6.
Para desarrolladores: qué se rompe al venir de Opus 5
Cambiar el identificador del modelo no basta. La guía de migración de Anthropic enumera cuatro cambios incompatibles y algunos cambios de comportamiento, que se manifiestan como errores 400 o como salidas sutilmente distintas si los pasas por alto.
| Cambio | Qué ocurre | Qué hacer |
|---|---|---|
| El razonamiento no se puede desactivar | thinking.type: "disabled" devuelve un 400 | Quita el campo thinking; controla la profundidad con output_config.effort |
| Se elimina el uso forzado de herramientas | tool_choice con any o tool devuelve un 400 | Usa auto con esquema de herramienta estricto, o salidas estructuradas |
| Bloques de razonamiento ligados al modelo y al prefijo | Opus 5.5 no lee el razonamiento de Fable o Mythos; cambiar el prompt de sistema, las herramientas o los mensajes previos devuelve un 400 por defecto | Usa la cabecera beta thinking-binding-controls-2026-08-01 con prefix_mismatch_behavior: "drop_block" para descartar los bloques afectados |
| Nueva herramienta de uso del ordenador | computer_20251124 no se admite en la API de Claude ni en Google Cloud | Pasa a computer_toolset_20260801 (Bedrock sigue aceptando la anterior) |
| El esfuerzo por defecto es Medium | En Opus 5 era High | Repite tus barridos de esfuerzo; fíjalo explícitamente si dependías de High |
| El texto de progreso vive en los bloques de razonamiento | El texto entre llamadas a herramientas se omite por defecto (thinking.display: "omitted") | Usa thinking.display: "updates" con la cabecera beta thinking-display-updates-2026-08-18 si emites mensajes de estado |
El modo Fast se activa con speed: "fast" bajo la cabecera beta fast-mode-2026-02-01 y solo existe en la API de Claude; Bedrock, Vertex AI y Foundry no lo ofrecen. El almacenamiento en caché de prompts necesita al menos 512 tokens para guardar algo.
¿Qué plan de Claude incluye Opus 5.5?
El anuncio es claro en tres puntos y calla en el resto. Dice que Anthropic amplía los límites de uso de cinco horas en los planes Pro, Max, Team y Enterprise por puesto, lo que equivale a decir que el modelo está disponible en esos planes, e introduce para los suscriptores un reinicio del límite de uso que «ahora puedes guardar y usar cuando quieras», es decir, un reinicio almacenado que activas cuando un límite de sesión llega en mal momento. No da un porcentaje para la ampliación, no menciona el plan Free y no dice si Opus 5.5 sustituye a Opus 5 como modelo por defecto. Como referencia, Opus 5 salió el 24 de julio como modelo por defecto en Max y como el más potente en Pro; si Anthropic repite el patrón, Opus 5.5 ocupará esos puestos, pero conviene mirar el selector de modelos en lugar de darlo por hecho.
| Plan | Opus 5.5 | Qué dice el anuncio |
|---|---|---|
| Free | No consta | El anuncio no menciona el plan Free |
| Pro | Sí | Límites de cinco horas ampliados; reinicio de límite acumulable |
| Max 5x y Max 20x | Sí | Límites de cinco horas ampliados; reinicio de límite acumulable |
| Team | Sí | Límites de cinco horas ampliados; reinicio de límite acumulable |
| Enterprise (por puesto) | Sí | Límites de cinco horas ampliados; retención cero de datos disponible |
| Claude Code | Sí | Incluido con el modo Fast; actualiza a la versión actual |
| API de Claude / Bedrock / Vertex AI / Foundry | Sí | claude-opus-5-5 a los precios indicados arriba |
¿Qué plan compensa? La cuenta ha cambiado en un punto concreto. Fable 5.1 está limitado al 50 % de tu cupo semanal en un plan Max y se mide con créditos en Pro, así que un uso intensivo de Fable empuja a subir de plan. Opus 5.5 es un modelo Opus normal con límites normales, y esos límites acaban de crecer, mientras el modelo gasta menos tokens por encargo. Si Fable 5.1 era tu único motivo para mirar Max, merece la pena probar antes Opus 5.5 en Pro para programación y redacción del día a día; deja Fable para los problemas en los que Opus en High o X-High aún se deja algo. Si encadenas sesiones de Claude Code durante horas o ejecutas varios agentes a la vez, los niveles Max siguen estando pensados para eso, y Max 20x continúa siendo la opción con mayor capacidad de sesión.
Dónde encaja Hermanos License
Nuestra categoría Herramientas de IA reúne las suscripciones a asistentes que vendemos, con entrega digital a tu correo y a tu panel de cuenta y 15 días de soporte de la tienda en cada pedido. La disponibilidad cambia, así que cada ficha de producto muestra existencias, precio y detalles de entrega en vivo. Al cierre de este artículo, la categoría incluye:
| Producto | Qué obtienes | En qué ayuda con Opus 5.5 |
|---|---|---|
| Suscripción Claude Max 20x | El nivel de consumo más alto de Anthropic, con Opus 5.5 y Fable 5.1 (Fable hasta el 50 % de los límites semanales) y acceso completo a Claude Code y Cowork | Sesiones largas de Claude Code, varios agentes a la vez y alternar entre Opus 5.5 y Fable 5.1 sin créditos |
| Google AI Pro (Gemini): suscripción de 18 meses | El nivel de pago de Gemini durante 18 meses, entregado como enlace de activación | Un segundo asistente para investigar y contrastar las respuestas de Claude; integración con Google Workspace |
| Google AI Pro: Gemini Advanced + 5 TB de almacenamiento | Gemini Advanced más 5 TB de almacenamiento de Google | Espacio para los documentos, conjuntos de datos y repositorios que entregas a sesiones largas de agentes |
Añadimos nuevas suscripciones de IA a esta categoría en cuanto los proveedores las publican, así que conviene mirar la página de categoría más que esta tabla.
Opus 5.5 rinde mejor dentro del software que ya usas, y las combinaciones de la guía de Fable 5.1 siguen valiendo:
| Si usas Opus 5.5 para… | Combina bien con | Lo encuentras en |
|---|---|---|
| Programar y sesiones de Claude Code | Windows 11 Pro como equipo de desarrollo local en condiciones: Hyper-V, Windows Sandbox, BitLocker, alojamiento de Escritorio remoto | Windows 11 |
| Presentaciones, informes y análisis financiero | Microsoft Office, para que los .pptx y .xlsx que genera se abran exactamente como esperas | Licencias de Office |
| Diagramas de proceso y planes de proyecto | Microsoft Visio y Project: Opus esboza, tú afinas | Visio y Project |
| Trabajo de diseño y prototipos de interfaz | CorelDRAW o Figma para rematar los bocetos del modelo | Herramientas de diseño |
| Leer PDF, contratos y escaneos | Adobe Acrobat Pro para editar y firmar lo que el modelo resume | Adobe Acrobat Pro 2020 |
| Agentes que navegan por ti | Protección del equipo y una VPN, porque los agentes abren páginas que tú nunca ves | Antivirus y VPN |
| Auditorías SEO y planes de contenidos | Screaming Frog SEO Spider para los datos de rastreo que analiza el modelo | Screaming Frog SEO Spider |
Todas las licencias y suscripciones de Hermanos License se entregan de forma digital. Las suscripciones a Claude siguen sujetas a los términos de consumo de Anthropic, incluidos los límites de sesión y semanales.
Preguntas frecuentes
¿Es Opus 5.5 mejor que Fable 5.1?
En la tabla publicada por Anthropic puntúa por encima de Fable 5.1 en todos los benchmarks listados, al 40 % del precio por token. La redacción de Anthropic es más prudente: «rinde al nivel de Claude Fable 5.1 en la mayoría del trabajo». Fable 5.1 sigue siendo lo más alto de la gama y el modelo al que recurrir cuando Opus en esfuerzo High o X-High todavía se deja una condición.
¿Por qué un 5.5 y no Claude 6?
La empresa presenta Opus 5.5 como su primer lanzamiento desde que pidió «marcar el ritmo en la frontera»: mejorar eficiencia, alineamiento y salvaguardas en un modelo cuyos riesgos dice entender en buena medida, en lugar de dar un salto mayor de capacidad. Sonnet 5.5 y Haiku 5.5 llegarán en las próximas semanas «con muchas de las mismas mejoras de rendimiento, eficiencia y seguridad».
¿Puedo usar Opus 5.5 en el plan Free?
El anuncio nombra Pro, Max, Team y Enterprise por puesto, y no menciona Free. La respuesta definitiva está en el selector de modelos de tu cuenta.
¿Por qué mi conversación con Opus 5.5 cambió a Opus 4.8 u Opus 5?
Un clasificador de seguridad marcó la petición como ciberseguridad de mayor riesgo (la atiende Opus 4.8) o como biología de doble uso o desarrollo de LLM de frontera (la atiende Opus 5). La respuesta lleva la etiqueta del modelo que contestó. Quienes usaban Opus 5 no veían el desvío por biología: es nuevo con Opus 5.5, porque su capacidad en biología se considera comparable a la de Mythos 5.1.
¿De verdad es un 40 % más barato? El precio de lista solo bajó un 20 %.
Ambas cosas son ciertas. El precio por token bajó un 20 % (un 60 % en lecturas de caché). La cifra de «un 40 % menos de operar» es la estimación de Anthropic para cargas habituales e incluye que el modelo termina las tareas en menos pasos y tokens; los informes de clientes que hablan de entre un tercio y la mitad de los tokens encajan con ello, pero tu carga concreta caerá en algún punto propio.
¿Puedo desactivar el razonamiento para ahorrar?
No. El razonamiento adaptativo está siempre activo en Opus 5.5 y la API devuelve un error si intentas desactivarlo. Usa el parámetro de esfuerzo: en Low está el ahorro, y varios probadores dicen que iguala a Opus 5 en High.
¿Qué es el «reinicio del límite de uso»?
Un reinicio del límite de uso de tu sesión que ahora los suscriptores pueden guardar y activar cuando quieran, en vez de esperar a que se renueve la ventana de cinco horas. Anthropic lo introdujo junto con la ampliación de los límites de cinco horas en Pro, Max y Team.
Fuentes
Anthropic, «Introducing Claude Opus 5.5» (22 de septiembre de 2026) · Claude Platform Docs, «What's new in Claude Opus 5.5» y «Models overview» (identificadores de modelo, ventana de contexto, límites de salida, esfuerzo por defecto, cambios incompatibles) · Claude Platform Docs, «Pricing» (precios de lista, caché, batch, modo Fast y residencia de datos) · Claude Platform Docs, página del modelo «Claude Opus 5» (precios y fecha de lanzamiento de Opus 5) · Claude Help Center, «Why Claude switched models in your conversation» (desvío, etiquetado, ajuste) · Claude Help Center, notas de versión (22 de septiembre de 2026) · Anthropic, «Introducing Claude Opus 5» (24 de julio de 2026). Las cifras de benchmarks y las citas de clientes son datos publicados por Anthropic y no se han verificado de forma independiente.