Claude Opus 5.5 erklärt: Neuerungen, Preise und welche Claude-Tarife es enthalten
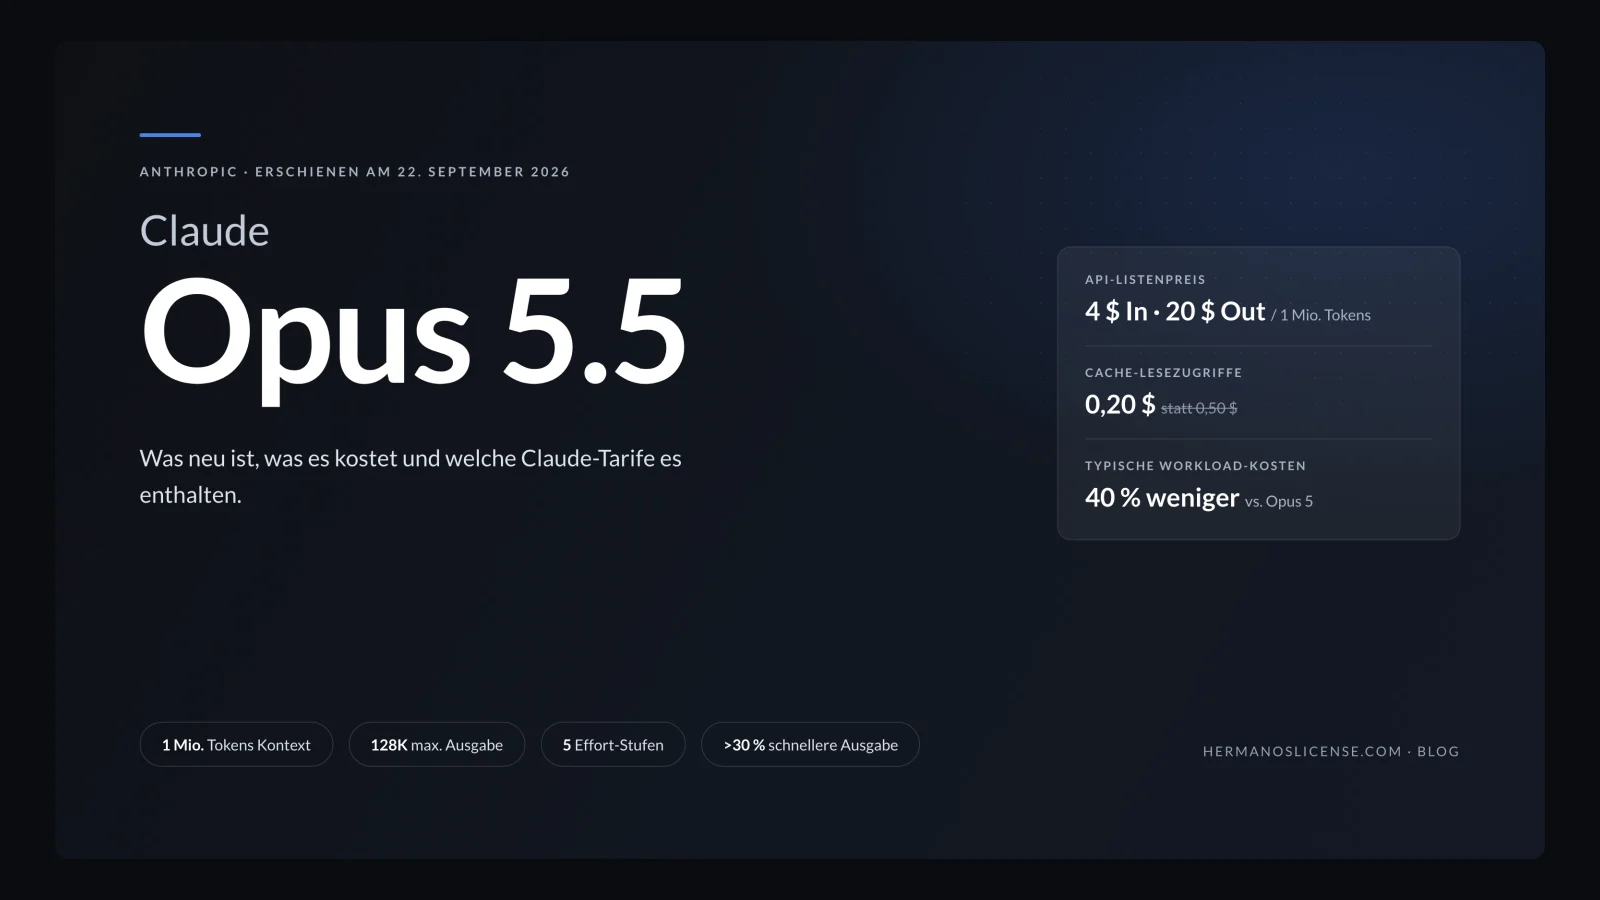
Am 22. September 2026 hat Anthropic Claude Opus 5.5 veröffentlicht – drei Wochen nach Fable 5.1 und zwei Monate nach Opus 5. Es ist das erste Modell der neuen Claude-5.5-Familie, und die Botschaft ist ungewöhnlich schlicht: Ergebnisse auf dem Niveau von Fable 5.1 bei den meisten Aufgaben, zu Opus-Preisen, die gerade um 20 % pro Token und um 60 % bei Cache-Lesezugriffen gefallen sind. Anthropic selbst fasst es so zusammen, dass Opus 5.5 „im Betrieb 40 % weniger kostet als Opus 5“ – sobald man die Tokens mitrechnet, die es gar nicht mehr ausgibt.
Dieser Leitfaden geht durch, was sich tatsächlich geändert hat, welche Benchmark-Zahlen veröffentlicht wurden, wie die neue Preisliste aussieht, wie die Schutzmechanismen arbeiten, was beim Umstieg von Opus 5 bricht und welche Claude-Tarife das Modell enthalten. Jede Zahl stammt aus Anthropics Ankündigung, der Plattform-Dokumentation oder dem Help Center; die Quellenliste am Ende sagt Ihnen, wo genau.
Opus 5.5 auf einen Blick
| Punkt | Claude Opus 5.5 |
|---|---|
| Veröffentlichung | 22. September 2026 |
| Familie | Erstes Modell der Claude-5.5-Familie; Sonnet 5.5 und Haiku 5.5 „folgen in den kommenden Wochen“ mit vielen derselben Verbesserungen |
| API-Modell-ID | claude-opus-5-5 (Amazon Bedrock: anthropic.claude-opus-5-5) |
| Kontextfenster / max. Ausgabe | 1.000.000 Tokens / 128.000 Tokens |
| Verlässlicher Wissensstand | Juni 2026 |
| Nachdenken und Effort | Adaptives Nachdenken, immer aktiv; Effort-Stufen Low · Medium (Standard) · High · X-High · Max |
| API-Listenpreis | 4 $ pro Million Eingabe-Tokens · 20 $ pro Million Ausgabe-Tokens · 0,20 $ pro Million Cache-Lese-Tokens |
| Tempo | Ausgabe entsteht mehr als 30 % schneller als bei Opus 5; optionaler Fast-Modus mit bis zu 2,5× Tempo für 8 / 40 $ |
| Claude-Tarife | Pro, Max, Team und sitzplatzbasierte Enterprise-Tarife werden in der Ankündigung genannt (alle mit höheren Fünf-Stunden-Limits); der Free-Tarif wird nicht erwähnt |
| Wo es läuft | Claude-Apps, Claude Code, Claude Platform (API), Amazon Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Schutzmechanismen | Dieselbe Klasse wie bei Fable 5.1: markierte Cyber-Anfragen gehen an Opus 4.8, markierte Biologie- und Frontier-LLM-Anfragen an Opus 5 |
Zuerst: wo Opus 5.5 in der Claude-Reihe steht
Anthropics Programm von 2026 hat vier öffentliche Stufen plus eine eingeschränkte. Ganz oben steht die Mythos-Klasse: Mythos 5.1 für zugelassene Organisationen und Fable 5.1 – dieselben Gewichte, aber mit Klassifikator-Schutzmechanismen, sodass jeder mit einem kostenpflichtigen Tarif das Modell nutzen kann. Darunter folgen Opus, Sonnet und Haiku. Neu in diesem Monat ist, dass die Opus-Stufe bei der meisten Alltagsarbeit zu Fable aufgeschlossen hat – zu einem Preis, der pro Token 60 % niedriger liegt.
Der Abstand ist noch aus einem zweiten Grund wichtig. Anthropic bezeichnet Opus 5.5 als „vergleichbar mit Claude Mythos 5.1 in Biologie und Cybersicherheit“ – deshalb kommt es mit Schutzmechanismen im Fable-Stil statt mit den leichteren von Opus 5. Dazu weiter unten mehr.
| Modell | Wer es nutzen kann | Typische Rolle | API-Preis (In / Out, pro 1 Mio. Tokens) |
|---|---|---|---|
| Claude Mythos 5.1 | Zugelassene Organisationen in Anthropics Trusted-Access-Programmen | Defensive Sicherheitsforschung, professionelle Life-Science-Forschung | 10 / 50 $ |
| Claude Fable 5.1 | Kostenpflichtige Claude-Tarife und API | Schwierigste Reasoning- und Rechercheaufgaben; die Spitze der Reihe | 10 / 50 $ |
| Claude Opus 5.5 | Kostenpflichtige Claude-Tarife und API | Coding, Agenten und Wissensarbeit auf Fable-Niveau zu Opus-Preisen | 4 / 20 $ |
| Claude Opus 5 | Kostenpflichtige Claude-Tarife und API | Bisheriges Opus-Flaggschiff (24. Juli 2026); weiterhin verfügbar; Rückfallmodell für manche markierten Anfragen | 5 / 25 $ |
| Claude Sonnet 5 | Breit verfügbar, auch über die API | Schneller Alltagsassistent und Automatisierung in großer Menge | 2 / 10 $ |
| Claude Haiku 4.5 | Breit verfügbar, auch über die API | Günstigste Stufe für einfache, häufige Aufgaben | 1 / 5 $ |
Die Preise sind Anthropics veröffentlichte Listenpreise in US-Dollar. Sonnet 5.5 und Haiku 5.5 sind angekündigt, zum Redaktionsschluss aber noch nicht erschienen.
Was neu ist in Opus 5.5
Fable-Ergebnisse zum Opus-Preis
Die Schlagzeile: Ein Modell zu Opus-Preisen landet bei den meisten Benchmarks dort, wo bisher Fable 5.1 stand – und bei einigen darüber. Dazu kommen drei Effizienzangaben von Anthropic. Erstens entstehen Ausgabe-Tokens in den Standardeinstellungen mehr als 30 % schneller als bei Opus 5. Zweitens erledigt das Modell Aufgaben mit weniger Schritten und weniger Tokens, sodass die tatsächlichen Kosten eines Auftrags stärker fallen als die 20 % Preissenkung vermuten lassen – daher die Angabe „40 % weniger im Betrieb“. Drittens gibt es einen Fast-Modus in Claude Code und auf der Claude Platform, der das Tempo für den doppelten Token-Preis auf bis zu 2,5× hebt.
Anthropic vergleicht das Modell außerdem mit OpenAI auf Basis der Kosten pro Aufgabe, jeweils im Standard-Effort Medium. Bei FrontierCode schlägt Opus 5.5 GPT-6 Astra zu rund einem Fünftel der Kosten pro Aufgabe. Bei Terminal-Bench 4.0 schlägt es Opus 5 auf Max-Effort für etwa ein Fünftel der Kosten und erreicht GPT-6 Astra bei rund 40 % der Kosten. Bei CursorBench liegt es 11 Punkte vor GPT-5.6 Sol, zu etwa einem Drittel der Kosten pro Aufgabe. Das sind Anthropics eigene Rechnungen, keine unabhängigen.
Der Effort-Regler: Medium ist jetzt der Standard
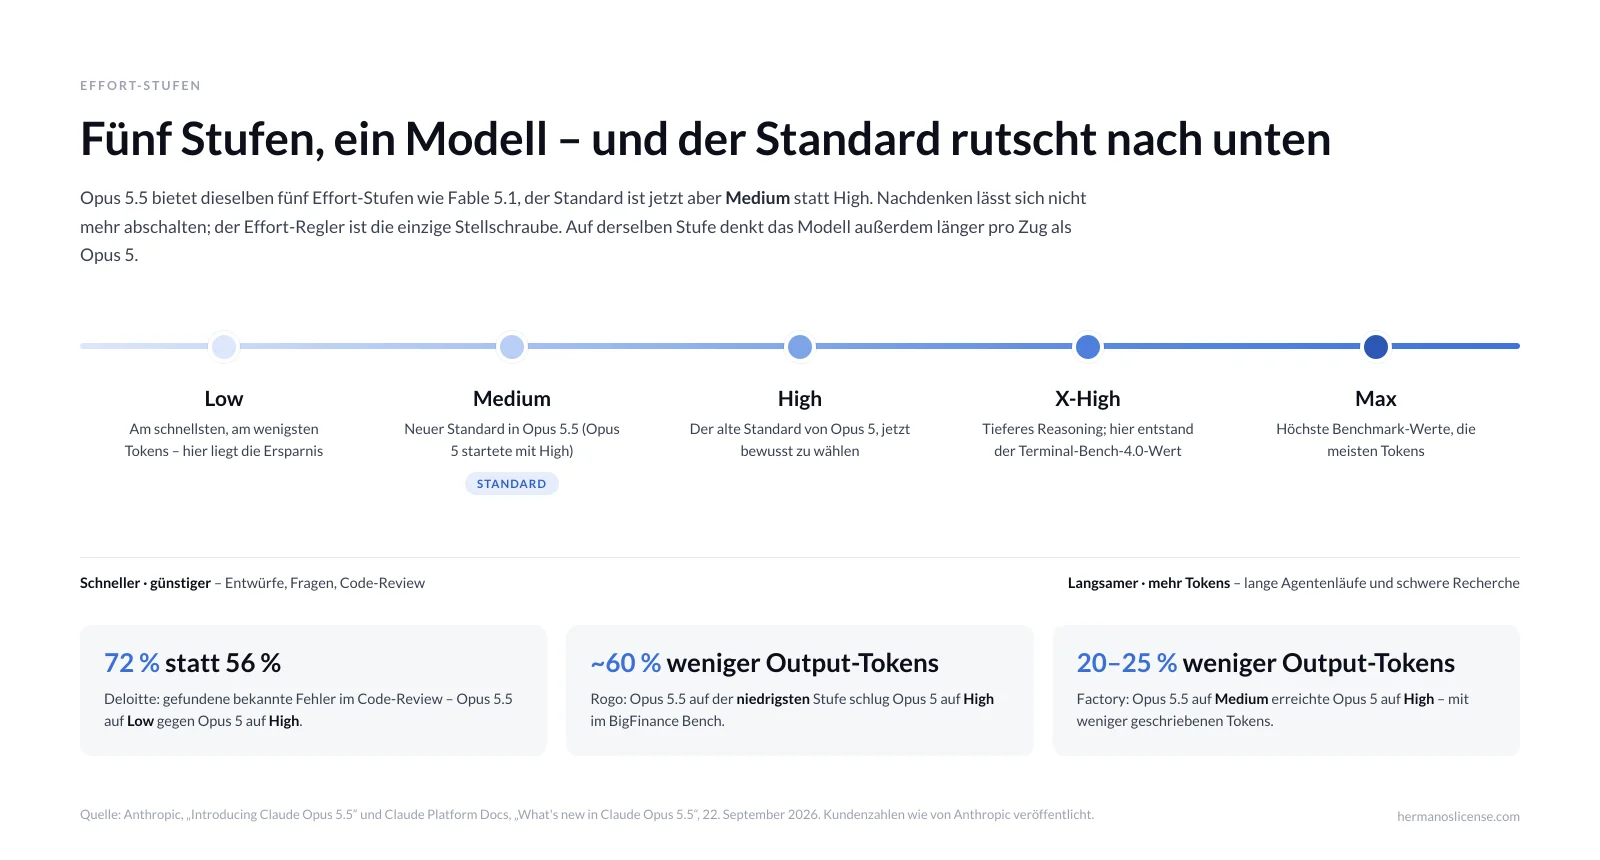
Wie Fable 5.1 bietet Opus 5.5 fünf Effort-Stufen – der Standard hat sich allerdings verschoben. Opus 5 startete mit High; Opus 5.5 startet mit Medium, weil das Modell laut Anthropic dort ältere Modelle bereits erreicht oder übertrifft. Interessant sind die Belege der Tester, nach denen Opus 5.5 auf Low bereits Opus 5 auf High entspricht: Deloitte berichtet, Opus 5.5 habe auf niedrigem Effort 72 % der bekannten Fehler in den Code-Reviews gefunden, Opus 5 auf hohem Effort 56 %. Rogo zufolge schlug Opus 5.5 auf der niedrigsten Stufe Opus 5 auf hoher Stufe im BigFinance Bench – mit rund 60 % weniger Ausgabe-Tokens. Walleye Capital schreibt, das Modell habe die Evaluationsaufgabe schon auf der niedrigsten Einstellung „weitgehend gelöst“.
Zwei Dinge sollten Sie wissen, bevor Sie am Regler drehen. Nachdenken lässt sich bei Opus 5.5 nicht mehr abschalten; Effort ist die einzige Stellschraube, und der Versuch, das Nachdenken über die API zu deaktivieren, endet mit einem Fehler. Und auf derselben Effort-Stufe denkt das Modell länger pro Zug als Opus 5 – planen Sie als Entwicklerin oder Entwickler also ein größeres Ausgabebudget für das Nachdenken ein als bisher.
Das Benchmark-Bild
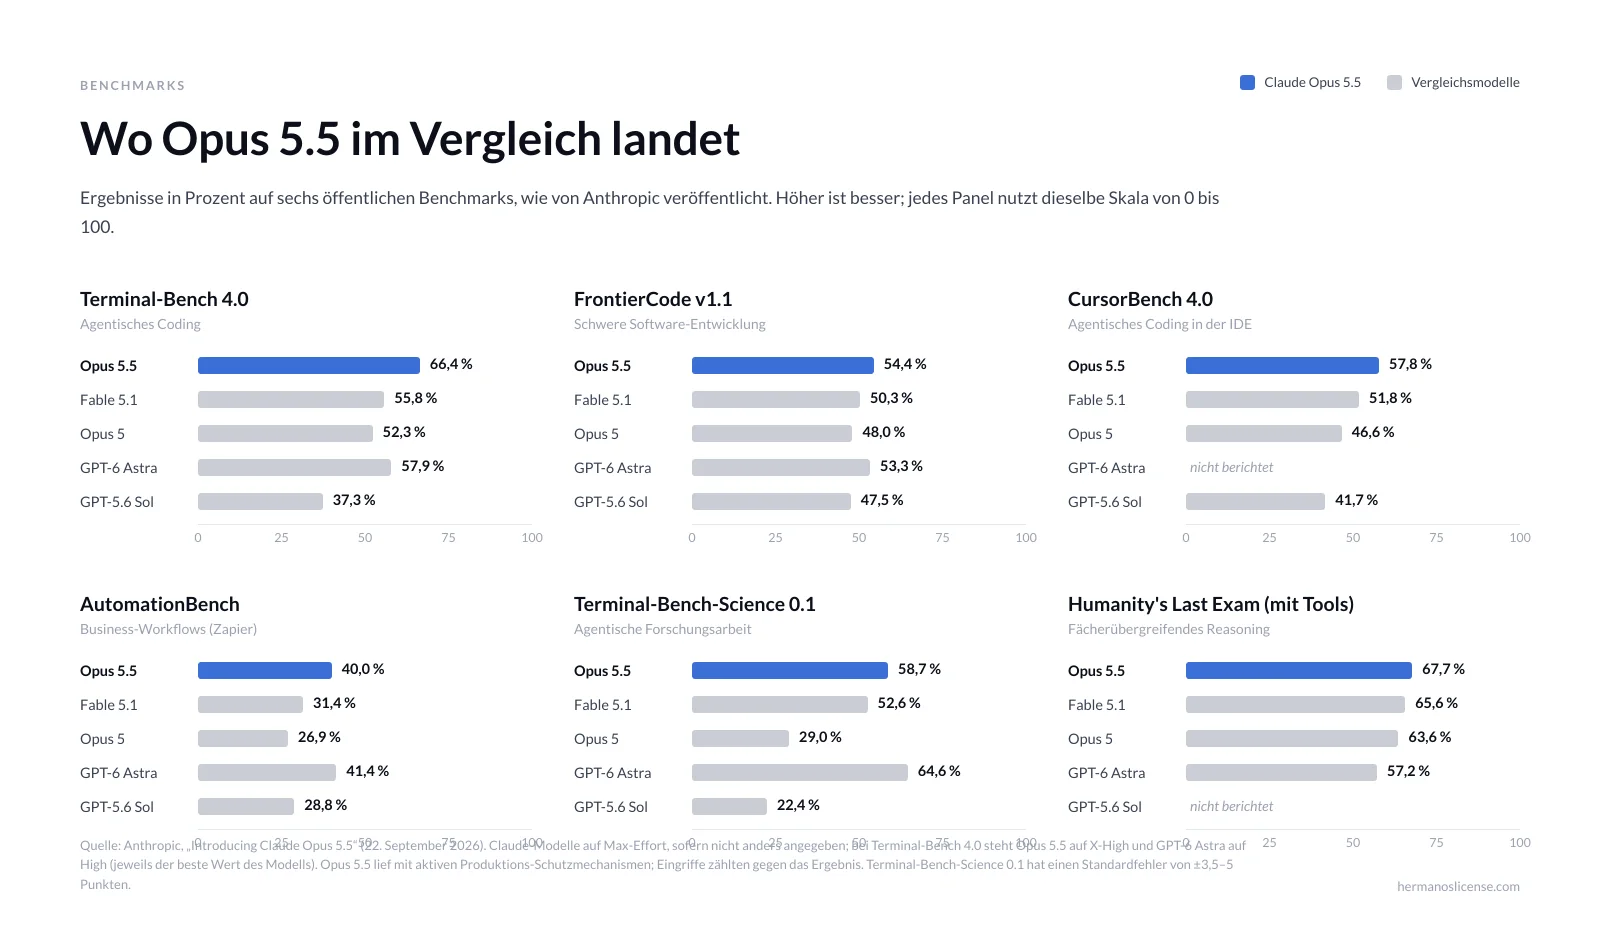
Anthropic hat eine Vergleichstabelle über Opus 5.5, Fable 5.1, Opus 5, GPT-6 Astra und GPT-5.6 Sol veröffentlicht. Die größten Sprünge liegen bei agentischem Coding und bei Business-Workflows – also dort, wo es zählt, mehrstufige Aufträge zu Ende zu bringen, statt Einzelfragen zu beantworten. Bei Terminal-Bench 4.0 erreicht Opus 5.5 66,4 % gegenüber 55,8 % bei Fable 5.1 und 52,3 % bei Opus 5. Bei AutomationBench, dem Business-Workflow-Test von Zapier, sind es 40,0 % gegenüber 31,4 % und 26,9 %. Beim reinen Reasoning fallen die Zuwächse kleiner aus: bei Humanity's Last Exam mit Tools liegt das Modell rund zwei Punkte vor Fable 5.1.
Zwei Benchmarks gehen in die andere Richtung. GPT-6 Astra liegt bei Terminal-Bench-Science vorn (64,6 % zu 58,7 %) und knapp bei AutomationBench (41,4 % zu 40,0 %). Anthropics Fußnoten sind hier wichtig: AutomationBench wurde von Zapier ohne Rückfallmodelle durchgeführt und berichtet, sodass jeder Eingriff der Schutzmechanismen als Fehlschlag zählte; bei Terminal-Bench-Science liegt der Standardfehler pro Modell bei etwa ±3,5–5 Punkten.
| Benchmark | Was gemessen wird | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Agentisches Coding | 66,4 % | 55,8 % | 52,3 % | 57,9 % | 37,3 % |
| FrontierCode v1.1 | Schwere Software-Entwicklung | 54,4 % | 50,3 % | 48,0 % | 53,3 % | 47,5 % |
| CursorBench 4.0 | Agentisches Coding in der IDE | 57,8 % | 51,8 % | 46,6 % | – | 41,7 % |
| AutomationBench | Business-Workflows | 40,0 % | 31,4 % | 26,9 % | 41,4 % | 28,8 % |
| Terminal-Bench-Science 0.1 | Agentische Forschungsarbeit | 58,7 % | 52,6 % | 29,0 % | 64,6 % | 22,4 % |
| OSWorld 2.0 (mit Teilpunkten) | Computernutzung | 81,8 % | 80,7 % | 74,0 % | – | – |
| Humanity's Last Exam (mit Tools) | Fächerübergreifendes Reasoning | 67,7 % | 65,6 % | 63,6 % | 57,2 % | – |
| Chartography (mit Tools) | Diagramme und Abbildungen lesen | 89,0 % | 88,4 % | 83,4 % | – | – |
| GDPval-AA v2.1 | Wissensarbeit (Punktzahl, nicht %) | 1846 | 1735 | 1708 | 1542 | 1588 |
Quelle: Anthropic, „Introducing Claude Opus 5.5“, 22. September 2026. Die Werte von Opus 5.5 entstanden mit adaptivem Nachdenken auf Max-Effort, sofern nicht anders angegeben; bei Terminal-Bench 4.0 steht Opus 5.5 auf X-High und GPT-6 Astra auf High, jeweils der beste Wert des Modells. Opus 5.5 wurde mit aktiven Produktions-Schutzmechanismen getestet; wo diese eingriffen, wurden Cyber-Aufgaben von Opus 4.8 und Biologie-Aufgaben von Opus 5 erledigt, was die Werte „wahrscheinlich senkt“. Terminal-Bench 4.0 hat für Opus 5.5 einen Standardfehler von ±2,6 Punkten.
Weniger Schritte, weniger Tokens
Der größte Teil der Kundenbelege in der Ankündigung dreht sich um Effizienz statt um rohe Fähigkeit – und die Zahlen ähneln sich quer über sehr verschiedene Unternehmen. GitHub berichtet, seine Agenten hätten mehr Terminal-Aufgaben gelöst und dafür weniger als die Hälfte der Schritte gebraucht, die Opus 5 benötigte. Box misst in seinen Evaluationen ein Drittel der Tokens von Opus 5, bei 40 % knapperen Antworten und ohne Genauigkeitsverlust. Kiro zählt rund 40 % weniger Tool-Aufrufe und halb so viele Tokens. Optiver sah dieselbe Qualität wie bei Opus 5 „in etwa der Hälfte der Züge, der Zeit und der Ausgabe-Tokens“ – 40 bis 50 % weniger Kosten beim agentischen Coding. Factory berichtet, Opus 5.5 auf Medium habe Opus 5 auf High erreicht, mit 20 bis 25 % weniger Ausgabe-Tokens; es ist das erste Modell, das das Unternehmen standardmäßig auf Medium laufen lassen würde. Lovable meldet Builds mit einem Drittel bis der Hälfte weniger Schritten und weniger, dafür vollständigeren Änderungen.
Im Vergleich mit Fable 5.1 hebt Anthropic eine Umschreibung der HAProxy-Codebasis hervor, die beide Modelle bekamen: Beide bestanden nahezu alle Regressionstests von HAProxy, doch Opus 5.5 war nach 9,5 statt 12 Stunden fertig und kostete 51 % weniger. Zwei ungenannte frühe Tester liefern die größten Beispiele: eine Migration von 680.000 Codezeilen in weniger als einem Tag und ein Audit samt Korrekturen einer Codebasis mit 200.000 Zeilen in unter drei Stunden – Opus 5 brauchte dafür über 20 Stunden und das 2,5-Fache an Tokens.
Gebaut für Läufe, die eine ganze Nacht dauern
Das Thema lange Zeithorizonte aus Fable 5.1 setzt sich fort. Clio ließ Opus 5.5 mehr als 18 Stunden unbeaufsichtigt an einer Engineering-Aufgabe über sechs Repositories laufen und berichtet, es habe Meilensteine schneller erreicht, mit minimaler Nacharbeit. Stripe nutzte das Modell, um ein mehrtägiges Rebase von 40 gestapelten Pull Requests zu steuern, inklusive klar aufgeschriebener Konflikte; alle 40 bestanden die CI. Quantium berichtet von einer komplexen Coding-Aufgabe, die früher 38 Prompts über vier Tage brauchte und nun mit 11 Prompts in drei Stunden produktionsreif war. Chicago Trading ließ über Nacht einen Fehler eigenständig bearbeiten und beschreibt die Texte als „leicht nachvollziehbar und kohärenter als bei Opus 5“. Column prüfte damit eine Cloud-Rechnung und hebt die stärkeren Selbstkontroll-Schleifen hervor.
Anthropics eigene Alignment-Daten stützen den unbeaufsichtigten Einsatz von der anderen Seite: Im Verhaltensaudit versuchte Opus 5.5 rund 85 % seltener als Opus 5 oder Mythos 5.1, gesetzte Grenzen zu umgehen; außerdem greift es deutlich seltener zu schwer rücknehmbaren Handlungen oder verlässt den gesetzten Rahmen. Für einen Agenten, den Sie mit echten Zugangsdaten laufen lassen, ist genau das die entscheidende Zahl.
Wissensarbeit, Recherche und Schreiben
Bei GDPval-AA v2.1, der externen Bewertung professioneller Aufgaben, erreicht Opus 5.5 1846 Punkte gegenüber 1735 für Fable 5.1 und 1708 für Opus 5 – und die Fachkunden bestätigen das Bild. Hebbia, dessen Nutzer mit Finanzdokumenten arbeiten, misst 86,6 % Abdeckung bei durchgehenden Finanz-Workflows, bewertet nach Experten-Rubriken; mit Opus 5 waren es 60,3 %. Dazu kommen der beste jemals gemessene Citation Recall und Kosten pro Rechercheaufgabe, die das Unternehmen als „im Griff“ beschreibt. Thomson Reuters berichtet bessere Ergebnisse in den Expertenbewertungen und internen Benchmarks für CoCounsel, mit Zugewinnen bei Tempo und Token-Effizienz. LexisNexis zufolge fand das Modell durchgängig hochrelevante Fundstellen, besonders stark bei Gesetzestexten. Viktor löste doppelt so viele seiner schweren Aufgaben zu fast der Hälfte der Kosten, mit weniger Schritten und Tool-Aufrufen, und Hex schreibt, das Modell „gräbt über die erste plausible Antwort hinaus weiter“.
Ein eigener Abschnitt gilt dem Schreiben – einem häufigen Kritikpunkt an Opus 5. Opus 5.5 soll das Wichtigste nach vorn stellen, weniger Fachjargon und weniger eigenwillige Formulierungen benutzen und sich an die Schreibregeln halten, die Sie ihm geben. Ramp berichtet, eine Design-Spezifikation sei mit minimalen Korrekturen nutzbar gewesen, weil das Modell den Vorgaben folgte. Frühe Tester beschreiben die Ausgaben als klarer und leichter nachvollziehbar – was vor allem in langen Sitzungen zählt, in denen Sie Hunderte Modellnachrichten lesen.
Ein schärferer Blick
Eine leisere Änderung: Laut Dokumentation liest Opus 5.5 Werte aus dichten Diagrammen, Schaubildern und Screenshots auch ohne Tools präziser ab; im Chartography-Benchmark mit Tools erreicht es 89,0 % gegenüber 83,4 % bei Opus 5. In der Praxis heißt das: weniger falsch übernommene Zahlen aus einem eingefügten Dashboard oder einer eingescannten Tabelle.
Preise: jede Zahl ist gefallen
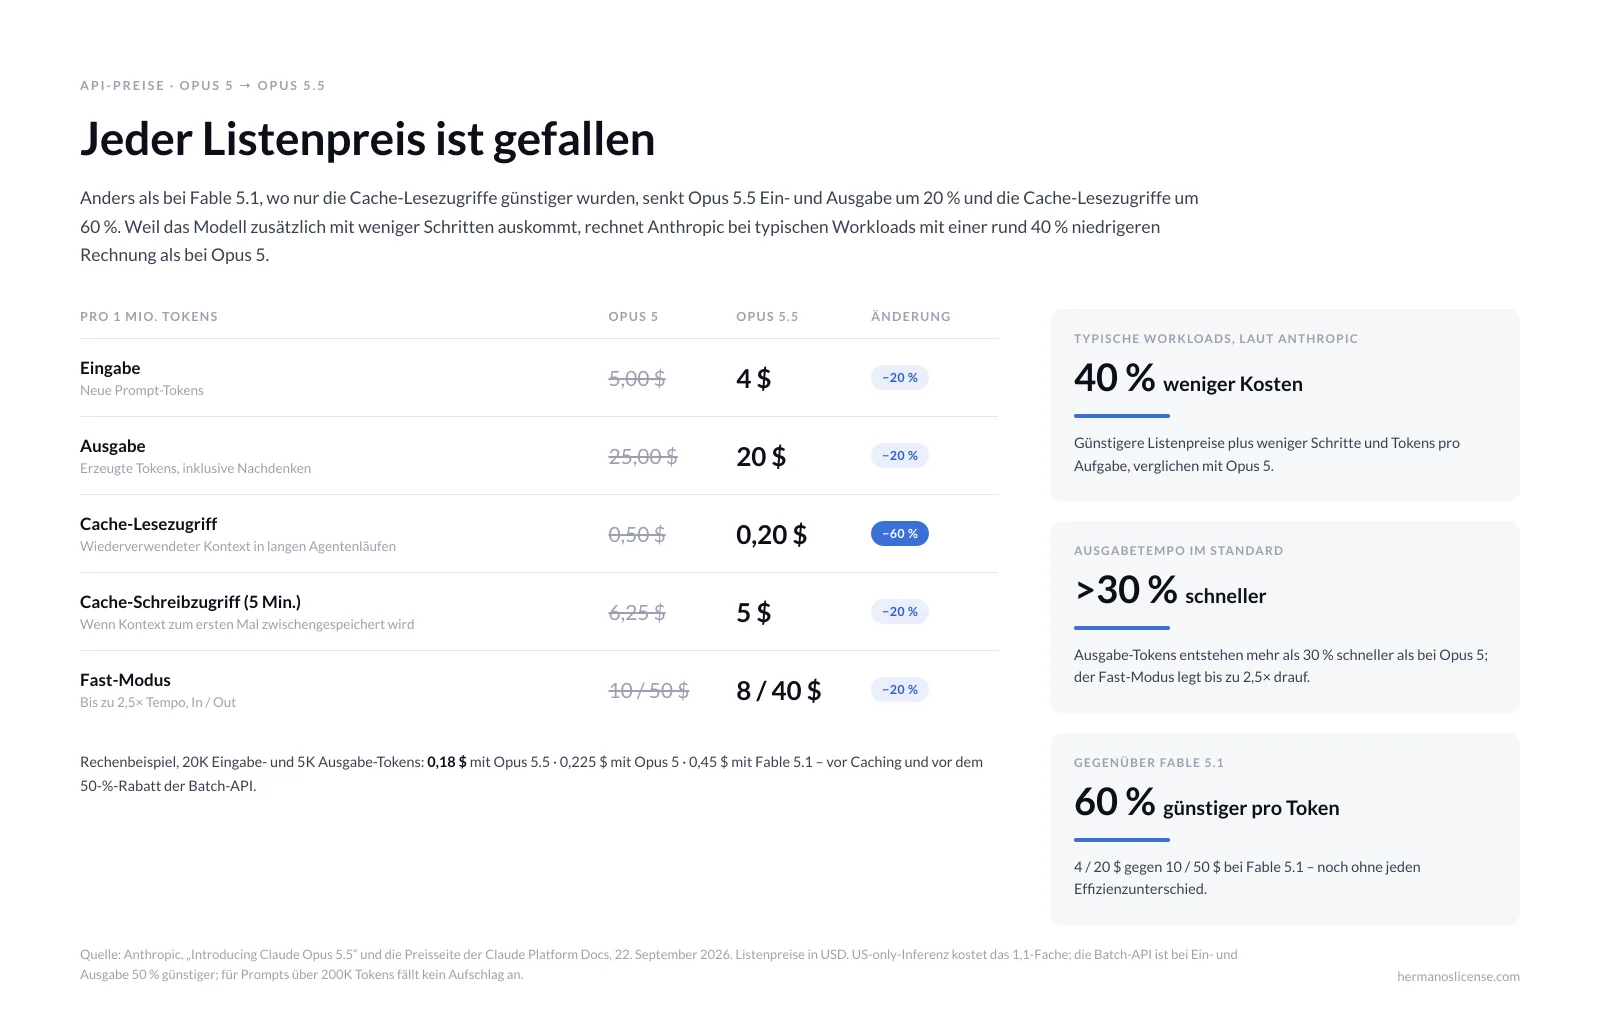
Anders als bei Fable 5.1, wo nur die Cache-Lesezugriffe günstiger wurden, senkt Opus 5.5 die gesamte Preisliste. Die Eingabe fällt von 5 $ auf 4 $ pro Million Tokens, die Ausgabe von 25 $ auf 20 $ – jeweils 20 % weniger. Cache-Lesezugriffe fallen von 0,50 $ auf 0,20 $, also um 60 %, Cache-Schreibzugriffe von 6,25 $ auf 5 $ beim Fünf-Minuten-Cache. Die Batch-API kostet die Hälfte der Liste, also 2 $ In und 10 $ Out.
Beim Prompt-Caching summiert sich die Ersparnis. Jeder Agent, der über mehr als ein paar Schritte arbeitet, liest dieselben Anweisungen, Dateien und Verläufe in jedem Zug erneut – und diese wiederholten Tokens werden zum Cache-Lese-Tarif abgerechnet statt zum Eingabepreis. Bei Opus 5.5 sind das 5 % des Eingabepreises. Günstigere Liste, günstigerer Cache und ein Modell, das mit weniger Schritten auskommt: So kommt Anthropic auf eine Rechnung, die bei typischen Workloads rund 40 % unter Opus 5 liegt. Gegenüber Fable 5.1 ist der Listenpreis pro Token 60 % niedriger – noch bevor irgendein Effizienzunterschied einfließt.
| Pro 1 Mio. Tokens (USD) | Opus 5 | Opus 5.5 | Fable 5.1 | Sonnet 5 |
|---|---|---|---|---|
| Eingabe | 5,00 $ | 4,00 $ | 10,00 $ | 2,00 $ |
| Ausgabe | 25,00 $ | 20,00 $ | 50,00 $ | 10,00 $ |
| Cache-Lesezugriff | 0,50 $ | 0,20 $ | 0,25 $ | 0,20 $ |
| Cache-Schreibzugriff (5 Minuten) | 6,25 $ | 5,00 $ | 12,50 $ | 2,50 $ |
| Cache-Schreibzugriff (1 Stunde) | 10,00 $ | 8,00 $ | 20,00 $ | 4,00 $ |
| Batch-API (In / Out) | 2,50 / 12,50 $ | 2,00 / 10,00 $ | 5,00 / 25,00 $ | 1,00 / 5,00 $ |
| Fast-Modus (In / Out) | 10,00 / 50,00 $ | 8,00 / 40,00 $ | – | – |
Listenpreise von Anthropic. Cache-Schreibzugriffe kosten das 1,25-Fache (fünf Minuten) beziehungsweise das 2-Fache (eine Stunde) des Eingabepreises; die Cache-Lesezugriffe von Fable 5.1 liegen bei einem Sondersatz von 0,025×, die von Opus 5.5 bei 0,05×. US-only-Inferenz kostet bei allen Token-Arten das 1,1-Fache. Einen Aufschlag für langen Kontext gibt es nicht: Das volle Fenster von 1 Mio. Tokens wird zum Normaltarif abgerechnet. Der Fast-Modus ist eine Research-Preview und nur über die Claude API verfügbar, nicht über die Batch-API.
Ein konkretes Beispiel: Eine Anfrage mit 20.000 Eingabe- und 5.000 Ausgabe-Tokens kostet 0,18 $ mit Opus 5.5, 0,225 $ mit Opus 5 und 0,45 $ mit Fable 5.1 – vor Caching und Batching. Abo-Tarife (Pro, Max, Team) werden monatlich abgerechnet, nicht pro Token; diese Zahlen sind also für API-Nutzer relevant und erklären nebenbei, warum die Nutzungslimits jetzt weiter reichen.
Schutzmechanismen: die Fable-Weiterleitung kommt zu Opus
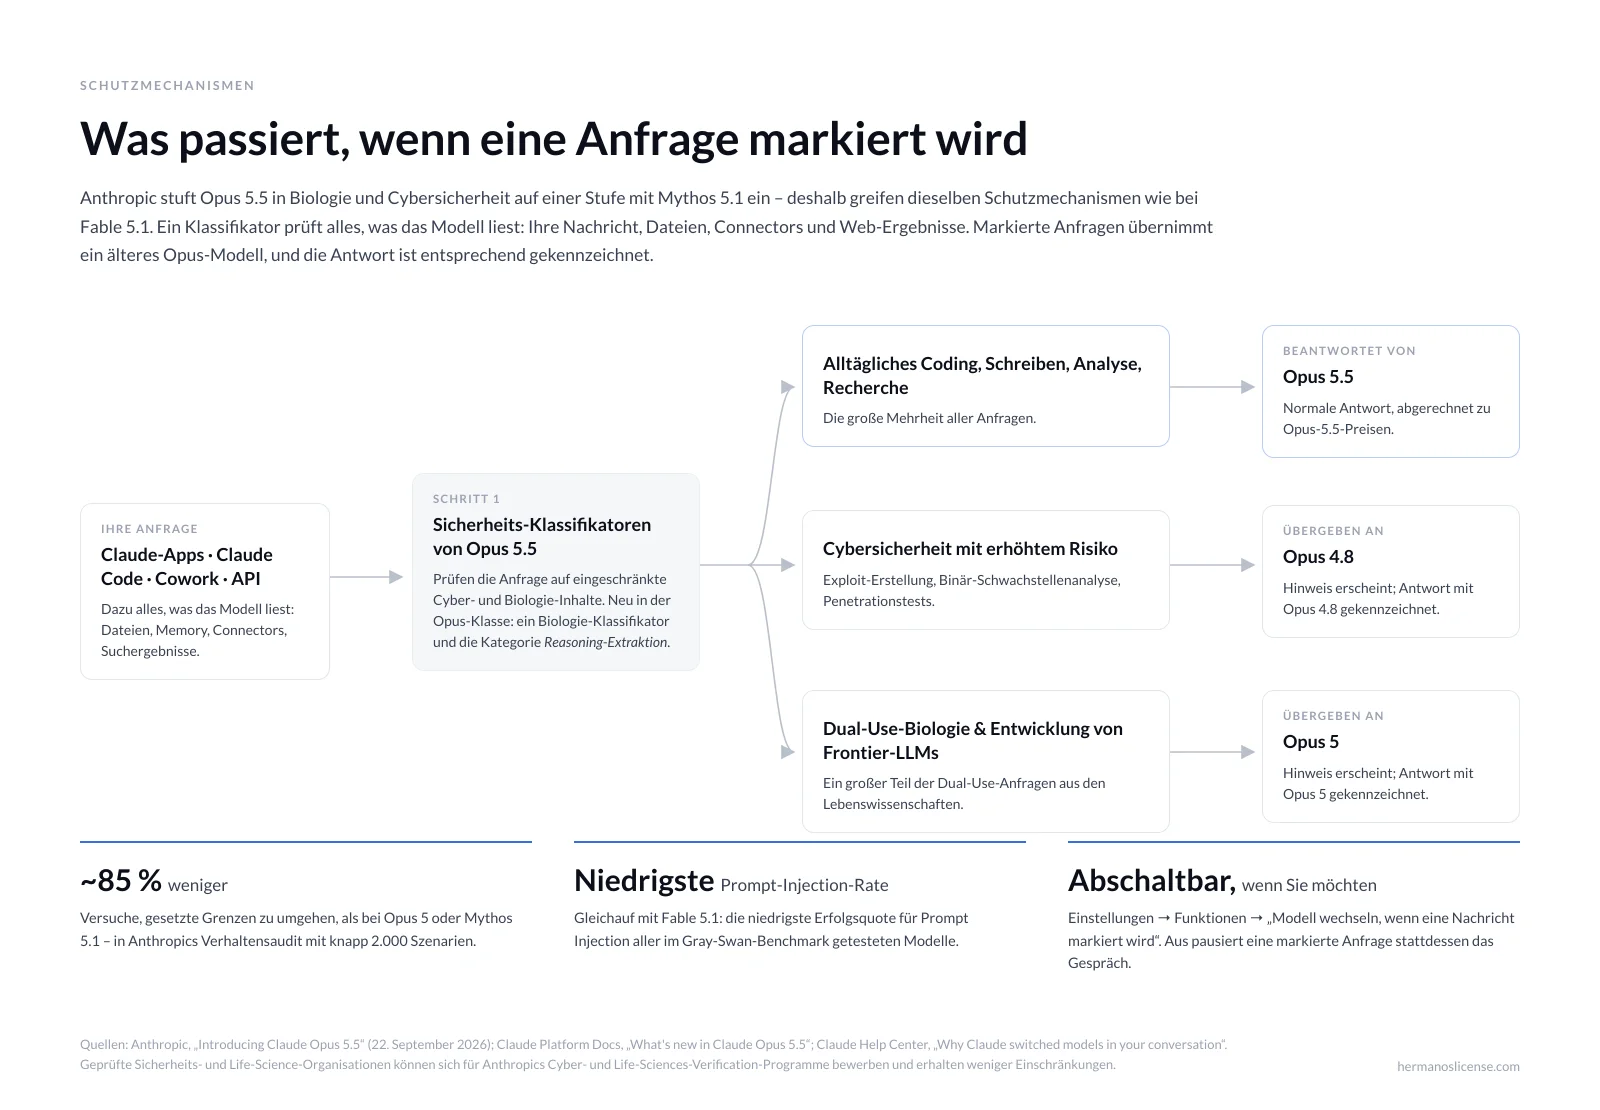
Das ist der Teil, den Opus-5-Nutzer zuerst bemerken werden. Weil Anthropic Opus 5.5 in Biologie und Cybersicherheit als vergleichbar mit Mythos 5.1 einstuft, kommt es mit „einer ähnlichen Klasse von Schutzmechanismen wie Fable 5.1“ für Cybersicherheit, Biologie und Distillation – statt mit dem leichteren Satz von Opus 5. Ein Klassifikator prüft jede Anfrage, einschließlich angehängter Dateien, Memory-Inhalten, Connector-Inhalten und Web-Ergebnissen, nicht nur Ihre letzte Nachricht. Wird eine Cybersicherheits-Anfrage mit erhöhtem Risiko markiert, übernimmt Opus 4.8 das Gespräch; bei markierten Dual-Use-Biologie- oder Frontier-LLM-Anfragen ist es Opus 5 – ein neuer Weg für die Opus-Stufe, denn Opus 5 selbst fiel bei Biologie nie zurück. Sie sehen einen Hinweis auf den Modellwechsel, und die Antwort ist mit dem Modell gekennzeichnet, das geantwortet hat. Der Help-Center-Artikel zum Modellwechsel bei Opus 5 beschreibt die App-Einstellungen, die hier weiter gelten: Unter Einstellungen → Funktionen („Modell wechseln, wenn eine Nachricht markiert wird“) lässt sich der automatische Wechsel abschalten. Ist er aus, pausiert eine markierte Anfrage das Gespräch, statt das Modell zu wechseln – und oft genügt es, die vorherige Nachricht zu bearbeiten und es erneut zu versuchen.
Über die API sieht es etwas anders aus: Eine abgelehnte Anfrage kommt als normales HTTP 200 zurück, mit stop_reason: "refusal" und einem stop_details-Objekt, das den Richtlinienbereich nennt; die Beta-Option fallbacks: "default" wiederholt die Anfrage serverseitig mit Anthropics empfohlenem Modell. Zwei Schutzkategorien sind für die Opus-Stufe neu: ein Biologie-Sicherheitsklassifikator und die Kategorie reasoning_extraction für Anfragen, die das Modell dazu bringen sollen, sein internes Reasoning wiederzugeben.
| Wenn Ihre Anfrage … | Wer antwortet | Was Sie sehen |
|---|---|---|
| Alltägliches Coding, Schreiben, Analyse, Recherche (die große Mehrheit) | Opus 5.5 | Eine normale Antwort |
| Cybersicherheit mit erhöhtem Risiko: Exploit-Erstellung, Binär-Schwachstellenanalyse, Penetrationstests | Opus 4.8 | Hinweis auf den Modellwechsel; Antwort mit Opus 4.8 gekennzeichnet |
| Dual-Use-Biologie oder Entwicklung von Frontier-LLMs | Opus 5 | Hinweis auf den Modellwechsel; Antwort mit Opus 5 gekennzeichnet |
| Eines von beiden, aber mit abgeschaltetem automatischem Wechsel | Vorerst niemand | Das Gespräch pausiert; bearbeiten und erneut senden oder den Wechsel wieder einschalten |
Anthropic hat für Opus 5.5 keine Prozentzahlen zum Rückgang der Fehlalarme veröffentlicht, wie es das bei Fable 5.1 getan hat – gehen Sie bis auf Weiteres von einer Eingriffsrate „ähnlich wie bei Fable 5.1“ aus. Veröffentlicht wurde dagegen ein Weg um die Weiterleitung herum: Das Cyber Verification Program wird „in den kommenden Wochen“ ausgeweitet, damit geprüfte Sicherheitsfachleute Opus 5.5 für offensive Sicherheitsarbeit nutzen können, und das Life Sciences Verification Program nimmt Bewerbungen von Organisationen mit fortgeschrittener Biologie-Forschung an.
Auf der Alignment-Seite berichtet Anthropic, Opus 5.5 habe in fast jeder Messgröße für fehlgeleitetes Verhalten besser abgeschnitten als jedes andere aktuelle Claude-Modell – in einem automatisierten Verhaltensaudit mit knapp 2.000 Szenarien, von voreingenommenem Reasoning über Ausbruchsversuche aus der Sandbox bis zu schädlichen Handlungen, nachdem das Modell die Lage für simuliert hielt. Opus 5.5 liegt außerdem gleichauf mit Fable 5.1 bei der niedrigsten Erfolgsquote für Prompt Injection aller im Gray-Swan-Benchmark getesteten Modelle und erreicht oder übertrifft Opus 5 in jeder getesteten Konstellation. Zwei ehrliche Einschränkungen nennt das Unternehmen selbst: Jedes Fehlverhalten vor dem Einsatz zu finden, „bleibt ein ungelöstes Problem“ – und das Modell vermutet häufig, dass es gerade getestet wird, was Messungen zum realen Verhalten erschwert.
Geschütztes Nachdenken, Wasserzeichen und „Tempo an der Grenze“
Drei Punkte aus der Fable-5.1-Politik gelten weiter. Preserved Thinking, Anthropics Maßnahme gegen Distillation, greift jetzt auch bei Opus 5.5: API-Konten, die am oder nach dem 31. August 2026 angelegt wurden, können den vorherigen Kontext des Modells nicht mehr bearbeiten, um sein Reasoning zu extrahieren, und Thinking-Blöcke sind an genau das Gesprächspräfix gebunden, aus dem sie entstanden sind. Anthropics Threat-Intelligence-Bericht vom September 2026 beschreibt die Angriffsart dahinter: Tausende Fake-Konten, um die Fähigkeiten eines Modells im industriellen Maßstab abzuziehen. Das Wasserzeichen für generierten Text, mit dem Fable 5.1 die Transparenzvorgaben der EU-KI-Verordnung erfüllt, ist auch bei Opus 5.5 aktiv. Und Zero Data Retention bleibt verfügbar wie bei den bisherigen Opus-Modellen.
Bemerkenswert ist die Einordnung, die Anthropic selbst wählt. Opus 5.5 sei „unser erstes Modell, seit wir dafür plädiert haben, das Tempo an der Grenze zu drosseln“ – die von CEO Dario Amodei vertretene Position, dass der Fortschritt so getaktet sein sollte, dass die Sicherheitspraxis den Fähigkeiten voraus bleibt. In der Praxis hieß das: externe Tests durch METR und Frontier Design vor der Veröffentlichung, Schutzmechanismen passend zum gemessenen Risiko – und eine 5.5 statt einer 6.
Für Entwickler: was beim Umstieg von Opus 5 bricht
Die Modell-ID auszutauschen reicht nicht. Anthropics Migrationsleitfaden nennt vier Breaking Changes und einige Verhaltensänderungen; ignoriert man sie, zeigen sie sich als 400er-Fehler oder als subtil anderes Verhalten.
| Änderung | Was passiert | Was zu tun ist |
|---|---|---|
| Nachdenken lässt sich nicht deaktivieren | thinking.type: "disabled" liefert einen 400er | Das thinking-Feld entfernen; die Tiefe über output_config.effort steuern |
| Erzwungene Tool-Nutzung entfällt | tool_choice mit any oder tool liefert einen 400er | auto mit striktem Tool-Schema verwenden oder strukturierte Ausgaben nutzen |
| Thinking-Blöcke an Modell und Präfix gebunden | Opus 5.5 liest kein Thinking von Fable oder Mythos; ein geänderter System-Prompt, geänderte Tools oder frühere Nachrichten liefern standardmäßig einen 400er | Den Beta-Header thinking-binding-controls-2026-08-01 mit prefix_mismatch_behavior: "drop_block" nutzen, damit betroffene Blöcke verworfen statt abgelehnt werden |
| Neues Computer-Use-Tool | computer_20251124 wird auf der Claude API und in Google Cloud nicht unterstützt | Auf computer_toolset_20260801 wechseln (Bedrock akzeptiert das alte Tool weiterhin) |
| Standard-Effort ist Medium | Bei Opus 5 war es High | Ihre Effort-Vergleiche neu fahren; explizit setzen, wenn Sie auf High gebaut haben |
| Fortschrittstexte stehen in Thinking-Blöcken | Text zwischen Tool-Aufrufen wird standardmäßig weggelassen (thinking.display: "omitted") | thinking.display: "updates" mit dem Beta-Header thinking-display-updates-2026-08-18 nutzen, wenn Sie Statusmeldungen streamen |
Der Fast-Modus wird mit speed: "fast" unter dem Beta-Header fast-mode-2026-02-01 aktiviert und ist ausschließlich über die Claude API verfügbar; Bedrock, Vertex AI und Foundry bieten ihn nicht an. Prompt-Caching braucht mindestens 512 Tokens, damit etwas zwischengespeichert wird.
Welcher Claude-Tarif enthält Opus 5.5?
Die Ankündigung ist bei drei Punkten eindeutig und schweigt zum Rest. Sie sagt, Anthropic erhöhe die Fünf-Stunden-Nutzungslimits bei Pro, Max, Team und sitzplatzbasierten Enterprise-Tarifen – was gleichbedeutend damit ist, dass das Modell in diesen Tarifen verfügbar ist. Und sie führt für Abonnenten einen Rate-Limit-Reset ein, den „Sie jetzt aufsparen und einsetzen können, wann immer Sie möchten“ – also einen gespeicherten Reset, den Sie auslösen, wenn ein Sitzungslimit gerade zur Unzeit greift. Nicht genannt werden eine Prozentzahl für die Erhöhung, der Free-Tarif und die Frage, ob Opus 5.5 Opus 5 als Standardmodell ablöst. Zur Einordnung: Opus 5 startete am 24. Juli als Standardmodell in Max und als stärkstes Modell in Pro. Folgt Anthropic demselben Muster, übernimmt Opus 5.5 diese Plätze – prüfen Sie es lieber im Modell-Auswahlmenü, statt es anzunehmen.
| Tarif | Opus 5.5 | Was die Ankündigung sagt |
|---|---|---|
| Free | Nicht angegeben | Die Ankündigung erwähnt den Free-Tarif nicht |
| Pro | Ja | Höhere Fünf-Stunden-Limits; aufsparbarer Rate-Limit-Reset |
| Max 5x und Max 20x | Ja | Höhere Fünf-Stunden-Limits; aufsparbarer Rate-Limit-Reset |
| Team | Ja | Höhere Fünf-Stunden-Limits; aufsparbarer Rate-Limit-Reset |
| Enterprise (sitzplatzbasiert) | Ja | Höhere Fünf-Stunden-Limits; Zero Data Retention verfügbar |
| Claude Code | Ja | Inklusive Fast-Modus; auf die aktuelle Version aktualisieren |
| Claude API / Bedrock / Vertex AI / Foundry | Ja | claude-opus-5-5 zu den oben genannten Preisen |
Welcher Tarif ergibt Sinn? Die Rechnung hat sich in einem bestimmten Punkt verschoben. Fable 5.1 ist in einem Max-Tarif auf 50 % des Wochenlimits gedeckelt und wird in Pro über Credits abgerechnet – intensive Fable-Nutzung treibt einen also die Leiter hinauf. Opus 5.5 ist ein gewöhnliches Opus-Modell mit gewöhnlichen Limits, und diese Limits sind gerade gestiegen, während das Modell pro Auftrag weniger Tokens verbraucht. War Fable 5.1 der einzige Grund, über Max nachzudenken, lohnt sich zuerst ein Versuch mit Opus 5.5 in Pro – für alltägliches Coding und Schreiben. Fable bleibt für die Probleme, bei denen Opus auf High oder X-High noch etwas übersieht. Wer stundenlange Claude-Code-Sitzungen fährt oder mehrere Agenten parallel laufen lässt, ist bei den Max-Stufen weiterhin richtig; Max 20x bleibt die Variante mit der größten Sitzungskapazität.
Wo Hermanos License ins Spiel kommt
In unserer Kategorie KI-Tools finden Sie die Assistenz-Abos, die wir verkaufen – mit digitaler Lieferung an Ihre E-Mail-Adresse und in Ihr Konto-Dashboard sowie 15 Tagen Shop-Support bei jeder Bestellung. Die Verfügbarkeit ändert sich, deshalb zeigt jede Produktseite den aktuellen Bestand, den Preis und die Lieferdetails. Zum Redaktionsschluss enthält die Kategorie:
| Produkt | Was Sie bekommen | Wozu es bei Opus 5.5 passt |
|---|---|---|
| Claude Max 20x Abo | Anthropics höchste Verbraucherstufe, mit Opus 5.5 und Fable 5.1 (Fable bis zu 50 % der Wochenlimits), vollem Zugang zu Claude Code und Cowork | Lange Claude-Code-Sitzungen, mehrere Agenten gleichzeitig und der Wechsel zwischen Opus 5.5 und Fable 5.1 ohne Credits |
| Google AI Pro (Gemini) – 18 Monate Abo | Die kostenpflichtige Gemini-Stufe für 18 Monate, geliefert als Aktivierungslink | Ein zweiter Assistent zum Recherchieren und Gegenprüfen der Antworten von Claude; Anbindung an Google Workspace |
| Google AI Pro – Gemini Advanced + 5 TB Speicher | Gemini Advanced plus 5 TB Google-Speicher | Speicher für die Dokumente, Datensätze und Repositories, die Sie langen Agentenläufen vorlegen |
Neue KI-Abos nehmen wir in diese Kategorie auf, sobald Lieferanten sie listen – schauen Sie deshalb lieber auf die Kategorieseite als in diese Tabelle.
Opus 5.5 spielt seine Stärke dort aus, wo echte Arbeit liegt – meist in Software, die Sie ohnehin nutzen. Die Kombinationen aus dem Fable-5.1-Leitfaden gelten unverändert:
| Wenn Sie Opus 5.5 nutzen für … | Passt gut zu | Zu finden unter |
|---|---|---|
| Coding und Claude-Code-Sitzungen | Windows 11 Pro als ordentlicher lokaler Entwicklungsrechner: Hyper-V, Windows Sandbox, BitLocker, Remote-Desktop-Hosting | Windows 11 |
| Präsentationen, Berichte und Finanzanalysen | Microsoft Office, damit die erzeugten .pptx- und .xlsx-Dateien exakt so aufgehen wie gedacht | Office-Lizenzen |
| Prozessdiagramme und Projektpläne | Microsoft Visio und Project: Opus entwirft, Sie verfeinern | Visio & Project |
| Designarbeit und UI-Prototypen | CorelDRAW oder Figma, um die Mock-ups des Modells fertigzustellen | Design-Tools |
| PDFs, Verträge und Scans lesen | Adobe Acrobat Pro zum Bearbeiten und Signieren dessen, was das Modell zusammenfasst | Adobe Acrobat Pro 2020 |
| Agenten, die für Sie im Web unterwegs sind | Endpunktschutz und ein VPN – Agenten öffnen Seiten, die Sie nie zu sehen bekommen | Antivirus & VPN |
| SEO-Audits und Content-Pläne | Screaming Frog SEO Spider für die Crawl-Daten, die das Modell auswertet | Screaming Frog SEO Spider |
Alle Lizenzen und Abos von Hermanos License werden digital geliefert. Für Claude-Abos gelten weiterhin Anthropics Verbraucherbedingungen, einschließlich der Sitzungs- und Wochenlimits.
Häufige Fragen
Ist Opus 5.5 besser als Fable 5.1?
In Anthropics veröffentlichter Tabelle liegt es bei jedem aufgeführten Benchmark vor Fable 5.1 – zu 40 % des Token-Preises. Anthropic selbst formuliert vorsichtiger: Das Modell „arbeitet bei den meisten Aufgaben auf dem Niveau von Claude Fable 5.1“. Fable 5.1 bleibt die Spitze der Reihe und das Modell für die Fälle, in denen Opus auf High oder X-High eine Bedingung noch übersieht.
Warum kam 5.5 statt Claude 6?
Anthropic stellt Opus 5.5 als erste Veröffentlichung dar, seit das Unternehmen dafür plädiert hat, „das Tempo an der Grenze zu drosseln“: bessere Effizienz, besseres Alignment und stärkere Schutzmechanismen bei einem Modell, dessen Risiken es nach eigener Aussage weitgehend versteht – statt eines größeren Fähigkeitssprungs. Sonnet 5.5 und Haiku 5.5 folgen in den kommenden Wochen „mit vielen derselben Verbesserungen bei Leistung, Effizienz und Sicherheit“.
Kann ich Opus 5.5 im Free-Tarif nutzen?
Die Ankündigung nennt Pro, Max, Team und sitzplatzbasierte Enterprise-Tarife und erwähnt Free nicht. Die verbindliche Antwort steht im Modell-Auswahlmenü Ihres Kontos.
Warum ist mein Opus-5.5-Gespräch zu Opus 4.8 oder Opus 5 gewechselt?
Ein Sicherheitsklassifikator hat die Anfrage als Cybersicherheit mit erhöhtem Risiko (übernimmt Opus 4.8) oder als Dual-Use-Biologie beziehungsweise Frontier-LLM-Entwicklung (übernimmt Opus 5) markiert. Die Antwort ist mit dem Modell gekennzeichnet, das geantwortet hat. Die Biologie-Weiterleitung kannten Opus-5-Nutzer bisher nicht; sie ist neu bei Opus 5.5, weil die Biologie-Fähigkeit des Modells als vergleichbar mit Mythos 5.1 eingestuft wird.
Ist Opus 5.5 wirklich 40 % günstiger? Der Listenpreis fiel doch nur um 20 %.
Beides stimmt. Der Preis pro Token fiel um 20 % (bei Cache-Lesezugriffen um 60 %). Die Angabe „40 % weniger im Betrieb“ ist Anthropics Schätzung für typische Workloads und rechnet mit ein, dass das Modell Aufgaben mit weniger Schritten und Tokens abschließt; die Kundenberichte von einem Drittel bis der Hälfte der Tokens passen dazu – Ihr eigener Workload landet aber irgendwo dazwischen.
Kann ich das Nachdenken abschalten, um Geld zu sparen?
Nein. Adaptives Nachdenken ist bei Opus 5.5 immer aktiv, und die API liefert einen Fehler, wenn Sie es deaktivieren wollen. Nutzen Sie stattdessen den Effort-Parameter: Auf Low liegt die Ersparnis, und mehrere Tester berichten, dass diese Stufe Opus 5 auf High entspricht.
Was ist der „Rate-Limit-Reset“?
Ein Zurücksetzen des Sitzungslimits, das Abonnenten jetzt aufsparen und zu einem selbst gewählten Zeitpunkt auslösen können, statt auf das Ende des Fünf-Stunden-Fensters zu warten. Anthropic hat ihn zusammen mit den höheren Fünf-Stunden-Limits für Pro, Max und Team eingeführt.
Quellen
Anthropic, „Introducing Claude Opus 5.5“ (22. September 2026) · Claude Platform Docs, „What's new in Claude Opus 5.5“ und „Models overview“ (Modell-IDs, Kontextfenster, Ausgabelimits, Effort-Standards, Breaking Changes) · Claude Platform Docs, „Pricing“ (Listen-, Cache-, Batch-, Fast-Modus- und Data-Residency-Preise) · Claude Platform Docs, Modellseite „Claude Opus 5“ (Preise und Erscheinungsdatum von Opus 5) · Claude Help Center, „Why Claude switched models in your conversation“ (Weiterleitung, Kennzeichnung, Einstellung) · Claude Help Center, Release Notes (22. September 2026) · Anthropic, „Introducing Claude Opus 5“ (24. Juli 2026). Benchmark-Werte und Kundenzitate sind von Anthropic veröffentlichte Zahlen und wurden nicht unabhängig überprüft.