Claude Opus 5.5 : nouveautés, prix et forfaits Claude qui l'incluent
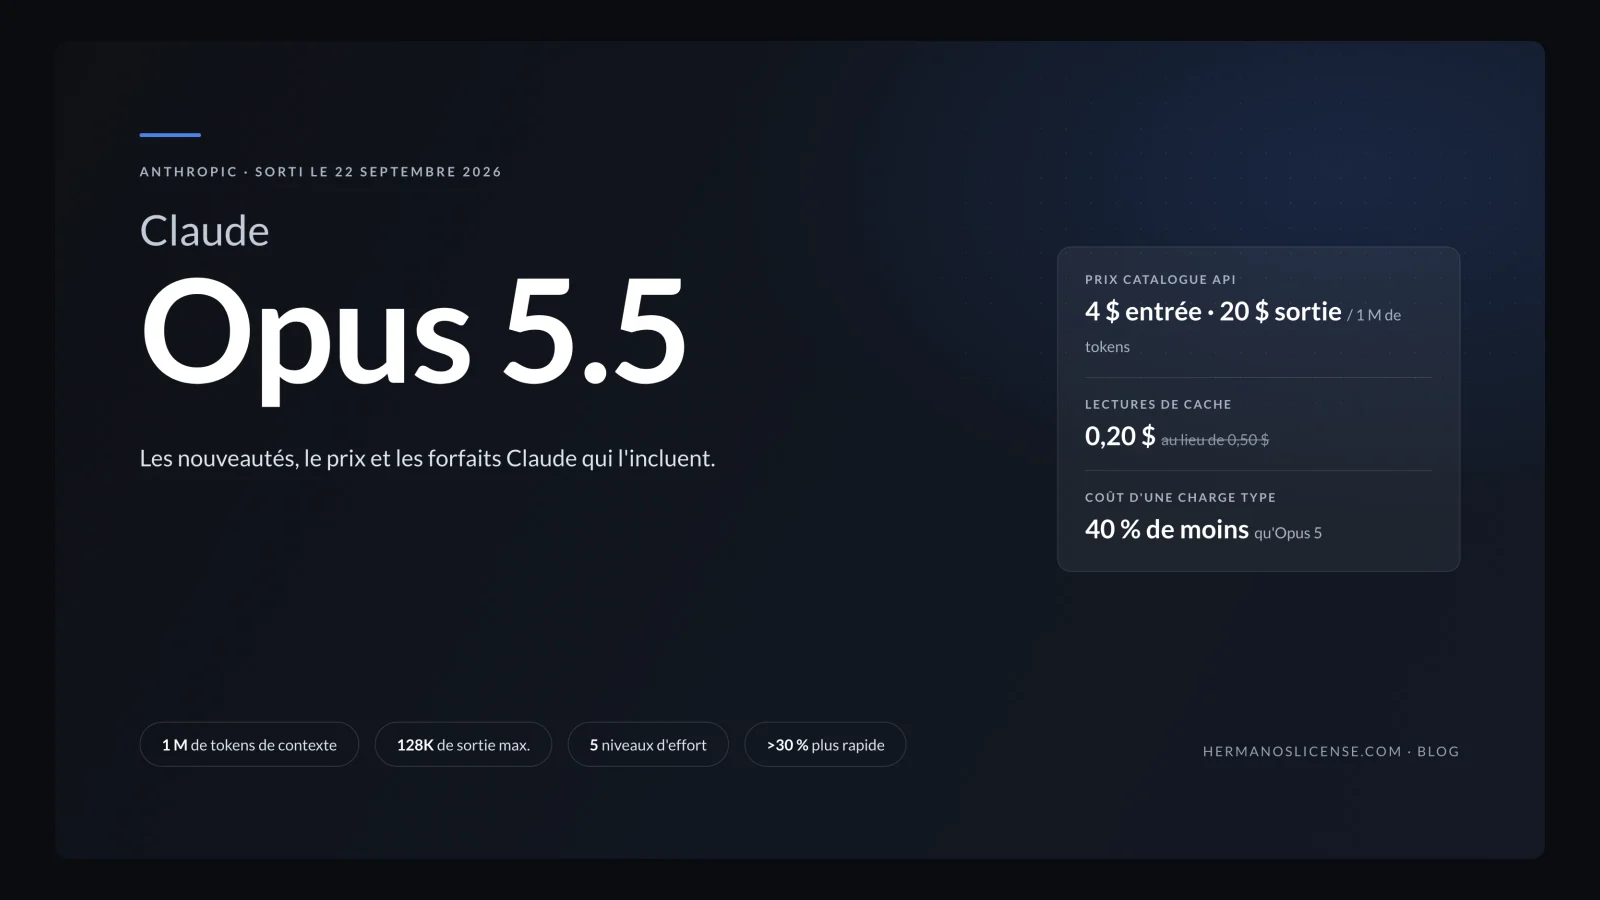
Le 22 septembre 2026, Anthropic a publié Claude Opus 5.5, trois semaines après Fable 5.1 et deux mois après Opus 5. C'est le premier modèle d'une nouvelle famille Claude 5.5, et la promesse est inhabituellement simple : des résultats au niveau de Fable 5.1 sur la plupart des travaux, à des tarifs Opus qui viennent de baisser de 20 % sur chaque token et de 60 % sur les lectures de cache. Anthropic résume la chose ainsi : Opus 5.5 « coûte 40 % de moins à faire tourner qu'Opus 5 », une fois comptés les tokens qu'il ne dépense plus.
Ce guide passe en revue ce qui a réellement changé, les chiffres de benchmarks publiés, la nouvelle grille tarifaire de l'API, le fonctionnement des garde-fous, ce qui casse si vous migrez du code depuis Opus 5, et les forfaits Claude qui donnent accès au modèle. Chaque chiffre provient de l'annonce de lancement d'Anthropic, de sa documentation ou de son centre d'aide ; la liste des sources en fin d'article indique où trouver quoi.
Opus 5.5 en bref
| Élément | Claude Opus 5.5 |
|---|---|
| Date de sortie | 22 septembre 2026 |
| Famille | Premier modèle de la famille Claude 5.5 ; Sonnet 5.5 et Haiku 5.5 « suivront dans les prochaines semaines » avec une grande partie des mêmes améliorations |
| Identifiant API | claude-opus-5-5 (Amazon Bedrock : anthropic.claude-opus-5-5) |
| Fenêtre de contexte / sortie max. | 1 000 000 de tokens / 128 000 tokens |
| Connaissances fiables jusqu'à | Juin 2026 |
| Raisonnement et effort | Raisonnement adaptatif, toujours actif ; niveaux d'effort Low · Medium (par défaut) · High · X-High · Max |
| Prix catalogue API | 4 $ par million de tokens en entrée · 20 $ par million en sortie · 0,20 $ par million de tokens de lecture de cache |
| Vitesse | Sortie générée plus de 30 % plus vite qu'Opus 5 ; mode Fast optionnel jusqu'à 2,5× pour 8 / 40 $ |
| Forfaits Claude | Pro, Max, Team et Enterprise par siège sont cités dans l'annonce (tous avec des limites sur cinq heures relevées) ; le forfait Free n'est pas mentionné |
| Où il tourne | Applications Claude, Claude Code, Claude Platform (API), Amazon Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Garde-fous | Même catégorie que Fable 5.1 : les requêtes cyber signalées vont à Opus 4.8, les requêtes biologie et développement de LLM de pointe à Opus 5 |
D'abord, la place d'Opus 5.5 dans la gamme Claude
La gamme 2026 d'Anthropic compte désormais quatre niveaux publics et un niveau restreint. Tout en haut, la classe Mythos : Mythos 5.1 pour les organisations agréées, et Fable 5.1, les mêmes poids assortis de garde-fous par classifieurs, ce qui le rend accessible à tout titulaire d'un forfait payant. En dessous viennent Opus, puis Sonnet, puis Haiku. La nouveauté du mois : le niveau Opus a rattrapé Fable sur l'essentiel du travail quotidien, tout en conservant un prix par token inférieur de 60 %.
L'écart compte pour une seconde raison. Anthropic décrit Opus 5.5 comme « comparable à Claude Mythos 5.1 en biologie et en cybersécurité » : c'est pourquoi il embarque des garde-fous de type Fable plutôt que les protections plus légères d'Opus 5. Nous y revenons plus bas.
| Modèle | Qui peut l'utiliser | Rôle habituel | Prix API (entrée / sortie, par 1 M de tokens) |
|---|---|---|---|
| Claude Mythos 5.1 | Organisations agréées dans les programmes d'accès de confiance d'Anthropic | Recherche défensive en sécurité, R&D professionnelle en sciences du vivant | 10 / 50 $ |
| Claude Fable 5.1 | Forfaits Claude payants et API | Les tâches de raisonnement et de recherche les plus difficiles ; le haut de la gamme | 10 / 50 $ |
| Claude Opus 5.5 | Forfaits Claude payants et API | Codage, agents et travail intellectuel au niveau de Fable, aux tarifs Opus | 4 / 20 $ |
| Claude Opus 5 | Forfaits Claude payants et API | Précédent fleuron Opus (24 juillet 2026) ; toujours servi ; modèle de repli pour certaines requêtes signalées | 5 / 25 $ |
| Claude Sonnet 5 | Largement disponible, API comprise | Assistant rapide du quotidien et automatisation à grand volume | 2 / 10 $ |
| Claude Haiku 4.5 | Largement disponible, API comprise | Le niveau le moins cher pour les tâches simples et fréquentes | 1 / 5 $ |
Il s'agit des prix catalogue publiés par Anthropic, en dollars américains. Sonnet 5.5 et Haiku 5.5 sont annoncés mais pas encore sortis à l'heure où nous écrivons.
Les nouveautés d'Opus 5.5
Des résultats Fable, une facture Opus
Le fait marquant : un modèle vendu au tarif Opus se place désormais là où Fable 5.1 se situait sur la plupart des benchmarks, et au-dessus sur plusieurs. Anthropic y ajoute trois arguments d'efficacité. D'abord, les tokens de sortie sont générés plus de 30 % plus vite qu'avec Opus 5 dans les réglages par défaut. Ensuite, le modèle termine les tâches en moins d'étapes et avec moins de tokens : le coût réel d'un travail baisse donc davantage que ne le laisse penser la réduction de 20 % du prix catalogue – d'où le chiffre de « 40 % de moins à faire tourner ». Enfin, un mode Fast, disponible dans Claude Code et sur la Claude Platform, pousse la vitesse jusqu'à 2,5× pour un prix au token doublé.
Anthropic compare aussi le modèle à ceux d'OpenAI sur la base du coût par tâche, toujours à l'effort Medium par défaut d'Opus 5.5. Sur FrontierCode, il devance GPT-6 Astra pour environ un cinquième du coût par tâche. Sur Terminal-Bench 4.0, il bat Opus 5 en effort Max pour environ un cinquième du coût et égale GPT-6 Astra pour environ 40 % du coût. Sur CursorBench, il devance GPT-5.6 Sol de 11 points pour environ un tiers du coût par tâche. Ce sont les calculs d'Anthropic, pas des mesures indépendantes.
Le curseur d'effort : Medium devient le réglage par défaut
Comme Fable 5.1, Opus 5.5 expose cinq niveaux d'effort, et le réglage par défaut a changé. Opus 5 démarrait sur High ; Opus 5.5 démarre sur Medium, parce qu'Anthropic constate que le modèle y égale ou dépasse déjà les modèles précédents. L'élément intéressant, ce sont les retours de testeurs pour qui Opus 5.5 en effort Low équivaut à Opus 5 en High : Deloitte indique qu'Opus 5.5 en effort bas a repéré 72 % des bugs connus lors de ses revues de code, contre 56 % pour Opus 5 en effort élevé ; Rogo affirme qu'Opus 5.5 à son effort le plus bas a devancé Opus 5 en effort élevé sur son BigFinance Bench, avec environ 60 % de tokens de sortie en moins ; Walleye Capital écrit que le modèle a « largement résolu » sa tâche d'évaluation au réglage le plus bas.
Deux points à connaître avant de toucher au curseur. Le raisonnement ne peut plus être désactivé sur Opus 5.5 : l'effort est le seul réglage, et demander à l'API de couper le raisonnement renvoie une erreur. Et, à niveau d'effort égal, le modèle réfléchit davantage par tour qu'Opus 5 : prévoyez donc un budget de sortie plus large pour le raisonnement qu'auparavant.

Le panorama des benchmarks
Anthropic a publié un tableau comparatif entre Opus 5.5, Fable 5.1, Opus 5, GPT-6 Astra et GPT-5.6 Sol. Les plus grands sauts concernent le codage agentique et les workflows métier, c'est-à-dire les épreuves qui récompensent le fait de mener à bien un travail en plusieurs étapes plutôt que de répondre à une question isolée. Sur Terminal-Bench 4.0, Opus 5.5 obtient 66,4 % contre 55,8 % pour Fable 5.1 et 52,3 % pour Opus 5. Sur AutomationBench, le test de workflows métier de Zapier, il atteint 40,0 % contre 31,4 % et 26,9 %. Les gains en raisonnement pur sont plus modestes : sur Humanity's Last Exam avec outils, le modèle devance Fable 5.1 d'environ deux points.
Deux benchmarks vont dans l'autre sens. GPT-6 Astra devance Opus 5.5 sur Terminal-Bench-Science (64,6 % contre 58,7 %) et de peu sur AutomationBench (41,4 % contre 40,0 %). Les notes de bas de page d'Anthropic comptent ici : AutomationBench a été exécuté et publié par Zapier sans modèles de repli, si bien que chaque intervention des garde-fous a compté comme un échec ; et sur Terminal-Bench-Science, l'erreur type est d'environ ±3,5–5 points par modèle.
| Benchmark | Ce qu'il mesure | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Codage agentique | 66,4 % | 55,8 % | 52,3 % | 57,9 % | 37,3 % |
| FrontierCode v1.1 | Génie logiciel difficile | 54,4 % | 50,3 % | 48,0 % | 53,3 % | 47,5 % |
| CursorBench 4.0 | Codage agentique dans l'IDE | 57,8 % | 51,8 % | 46,6 % | – | 41,7 % |
| AutomationBench | Workflows métier | 40,0 % | 31,4 % | 26,9 % | 41,4 % | 28,8 % |
| Terminal-Bench-Science 0.1 | Recherche scientifique agentique | 58,7 % | 52,6 % | 29,0 % | 64,6 % | 22,4 % |
| OSWorld 2.0 (points partiels) | Usage de l'ordinateur | 81,8 % | 80,7 % | 74,0 % | – | – |
| Humanity's Last Exam (avec outils) | Raisonnement pluridisciplinaire | 67,7 % | 65,6 % | 63,6 % | 57,2 % | – |
| Chartography (avec outils) | Lecture de graphiques et de figures | 89,0 % | 88,4 % | 83,4 % | – | – |
| GDPval-AA v2.1 | Travail intellectuel (note, pas un %) | 1846 | 1735 | 1708 | 1542 | 1588 |
Source : Anthropic, « Introducing Claude Opus 5.5 », 22 septembre 2026. Les résultats d'Opus 5.5 utilisent le raisonnement adaptatif en effort Max sauf mention contraire ; sur Terminal-Bench 4.0, Opus 5.5 est en X-High et GPT-6 Astra en High, soit le meilleur score de chaque modèle. Opus 5.5 a été testé avec ses garde-fous de production actifs ; lorsqu'ils sont intervenus, les tâches cyber ont été traitées par Opus 4.8 et les tâches biologie par Opus 5, ce qui « réduit probablement » ses scores. Terminal-Bench 4.0 comporte une erreur type de ±2,6 points pour Opus 5.5.

Moins d'étapes, moins de tokens
L'essentiel des retours clients publiés porte sur l'efficacité plutôt que sur la capacité brute, et les chiffres se recoupent d'une entreprise à l'autre. GitHub indique que ses agents ont résolu davantage de tâches en terminal en moins de la moitié des étapes nécessaires à Opus 5. Box rapporte qu'Opus 5.5 a consommé un tiers des tokens d'Opus 5 dans ses évaluations, avec des réponses 40 % moins verbeuses et sans perte de justesse. Kiro a mesuré environ 40 % d'appels d'outils en moins et deux fois moins de tokens. Optiver a obtenu la même qualité qu'avec Opus 5 « en environ moitié moins de tours, de temps et de tokens de sortie », soit 40 à 50 % de coût en moins sur le codage agentique. Factory indique qu'Opus 5.5 en effort Medium a égalé Opus 5 en High avec 20 à 25 % de tokens de sortie en moins – le premier modèle que l'entreprise laisserait par défaut sur Medium. Lovable constate des builds terminés avec un tiers à une moitié d'étapes en moins, avec des modifications moins nombreuses mais plus complètes.
Face à Fable 5.1, la comparaison mise en avant par Anthropic est la réécriture de la base de code HAProxy confiée aux deux modèles : tous deux ont passé la quasi-totalité des tests de non-régression de HAProxy, mais Opus 5.5 a terminé en 9,5 heures au lieu de 12 et a coûté 51 % de moins. Deux testeurs précoces non nommés fournissent les exemples les plus massifs : une migration de 680 000 lignes de code achevée en moins d'une journée, et l'audit puis la correction d'une base de 200 000 lignes en moins de trois heures, là où Opus 5 avait mis plus de 20 heures et consommé 2,5 fois plus de tokens.
Conçu pour des sessions qui durent toute la nuit
Le thème des longues durées entamé avec Fable 5.1 se poursuit. Clio a laissé Opus 5.5 travailler sans surveillance pendant plus de 18 heures sur une tâche d'ingénierie couvrant six dépôts, et rapporte des jalons atteints plus vite avec un minimum de reprises. Stripe l'a utilisé pour piloter un rebase de plusieurs jours portant sur 40 pull requests empilées, chaque conflit étant exposé clairement ; les 40 ont passé la CI. Quantium indique qu'une tâche de codage complexe qui demandait auparavant 38 prompts sur quatre jours a été traitée en 11 prompts et trois heures, dans un état prêt pour la production. Chicago Trading lui a fait corriger un bug de façon autonome pendant la nuit et juge sa rédaction « facile à suivre et plus cohérente que celle d'Opus 5 ». Column s'en est servi pour auditer une facture cloud et relève des boucles d'auto-vérification plus solides.
Les données d'alignement d'Anthropic confortent cet usage sans surveillance par l'autre bout : dans son audit comportemental, Opus 5.5 a tenté de contourner les limites qui lui étaient fixées environ 85 % moins souvent qu'Opus 5 ou Mythos 5.1, et il est décrit comme nettement moins enclin à des actions difficilement réversibles ou hors du cadre fixé. Pour un agent laissé en marche avec de véritables identifiants, c'est le chiffre à surveiller.
Travail intellectuel, recherche et rédaction
Sur GDPval-AA v2.1, l'évaluation tierce de tâches professionnelles, Opus 5.5 obtient 1846 contre 1735 pour Fable 5.1 et 1708 pour Opus 5, et les clients spécialisés vont dans le même sens. Hebbia, dont les utilisateurs travaillent sur des documents financiers, a mesuré 86,6 % de couverture sur des workflows financiers de bout en bout notés selon des grilles d'experts, contre 60,3 % avec Opus 5, avec son meilleur taux de rappel de citations à ce jour et un coût par tâche de recherche qu'elle qualifie de « maîtrisé ». Thomson Reuters signale de meilleurs résultats dans ses évaluations d'experts et ses benchmarks internes pour CoCounsel, avec des gains de vitesse et d'efficacité en tokens. LexisNexis indique que le modèle a identifié de façon constante des références hautement pertinentes, avec une force particulière sur les textes de loi. Viktor a résolu deux fois plus de ses tâches difficiles pour près de moitié moins cher, en moins d'étapes et d'appels d'outils, et Hex note que le modèle « continue de creuser au-delà de la première réponse plausible ».
Anthropic consacre aussi une section à la rédaction, un reproche fréquent adressé à Opus 5. Opus 5.5 est censé placer l'information la plus importante en premier, employer moins de jargon et moins de tournures idiosyncrasiques, et respecter les règles d'écriture que vous lui donnez. Ramp raconte qu'une spécification de design était utilisable avec un minimum de retouches parce que le modèle avait suivi ses règles. Les testeurs précoces décrivent des sorties plus claires et plus faciles à suivre – ce qui compte surtout dans les longues sessions où vous lisez des centaines de messages du modèle.
Un œil plus précis
Un changement plus discret : selon la documentation, Opus 5.5 lit plus précisément les valeurs dans les graphiques denses, les schémas et les captures d'écran, sans outils ; sur le benchmark Chartography avec outils, il obtient 89,0 % contre 83,4 % pour Opus 5. En pratique, cela signifie moins de chiffres mal repris d'un tableau de bord collé ou d'un tableau scanné.
Tarifs : tous les prix ont baissé
Contrairement à Fable 5.1, où seules les lectures de cache avaient baissé, Opus 5.5 réduit toute la grille. L'entrée passe de 5 $ à 4 $ par million de tokens et la sortie de 25 $ à 20 $, soit 20 % de baisse dans les deux cas. Les lectures de cache passent de 0,50 $ à 0,20 $, une baisse de 60 %, et les écritures de cache de 6,25 $ à 5 $ pour le cache de cinq minutes. L'API Batch coûte la moitié du catalogue, soit 2 $ en entrée et 10 $ en sortie.
C'est avec la mise en cache des prompts que l'économie se cumule. Tout agent qui travaille au-delà de quelques étapes relit les mêmes instructions, fichiers et historiques à chaque tour, et ces tokens répétés sont facturés au tarif de lecture de cache et non au tarif d'entrée. Avec Opus 5.5, ce tarif représente 5 % du prix d'entrée. Combinez un catalogue moins cher, un cache moins cher et un modèle qui termine en moins d'étapes : vous obtenez l'estimation d'Anthropic d'une facture environ 40 % plus basse qu'avec Opus 5 sur des charges classiques. Face à Fable 5.1, le prix catalogue est inférieur de 60 % par token, avant toute différence d'efficacité.
| Pour 1 M de tokens (USD) | Opus 5 | Opus 5.5 | Fable 5.1 | Sonnet 5 |
|---|---|---|---|---|
| Entrée | 5,00 $ | 4,00 $ | 10,00 $ | 2,00 $ |
| Sortie | 25,00 $ | 20,00 $ | 50,00 $ | 10,00 $ |
| Lecture de cache | 0,50 $ | 0,20 $ | 0,25 $ | 0,20 $ |
| Écriture de cache (5 minutes) | 6,25 $ | 5,00 $ | 12,50 $ | 2,50 $ |
| Écriture de cache (1 heure) | 10,00 $ | 8,00 $ | 20,00 $ | 4,00 $ |
| API Batch (entrée / sortie) | 2,50 / 12,50 $ | 2,00 / 10,00 $ | 5,00 / 25,00 $ | 1,00 / 5,00 $ |
| Mode Fast (entrée / sortie) | 10,00 / 50,00 $ | 8,00 / 40,00 $ | – | – |
Prix catalogue d'Anthropic. Les écritures de cache coûtent 1,25× (cinq minutes) et 2× (une heure) le prix d'entrée ; les lectures de cache de Fable 5.1 relèvent d'un taux spécial de 0,025× et celles d'Opus 5.5 de 0,05×. L'inférence limitée aux États-Unis applique un coefficient de 1,1 sur tous les types de tokens. Il n'y a pas de supplément pour le contexte long : la fenêtre complète de 1 M de tokens est facturée au tarif normal. Le mode Fast est une préversion de recherche réservée à l'API Claude et n'est pas disponible via l'API Batch.
Un exemple concret : une requête de 20 000 tokens en entrée et 5 000 en sortie coûte 0,18 $ avec Opus 5.5, 0,225 $ avec Opus 5 et 0,45 $ avec Fable 5.1, avant mise en cache ou traitement par lots. Les forfaits par abonnement (Pro, Max, Team) sont facturés au mois et non au token : ces chiffres intéressent donc les utilisateurs de l'API et expliquent au passage pourquoi les limites d'usage durent plus longtemps.

Garde-fous : l'aiguillage de Fable arrive chez Opus
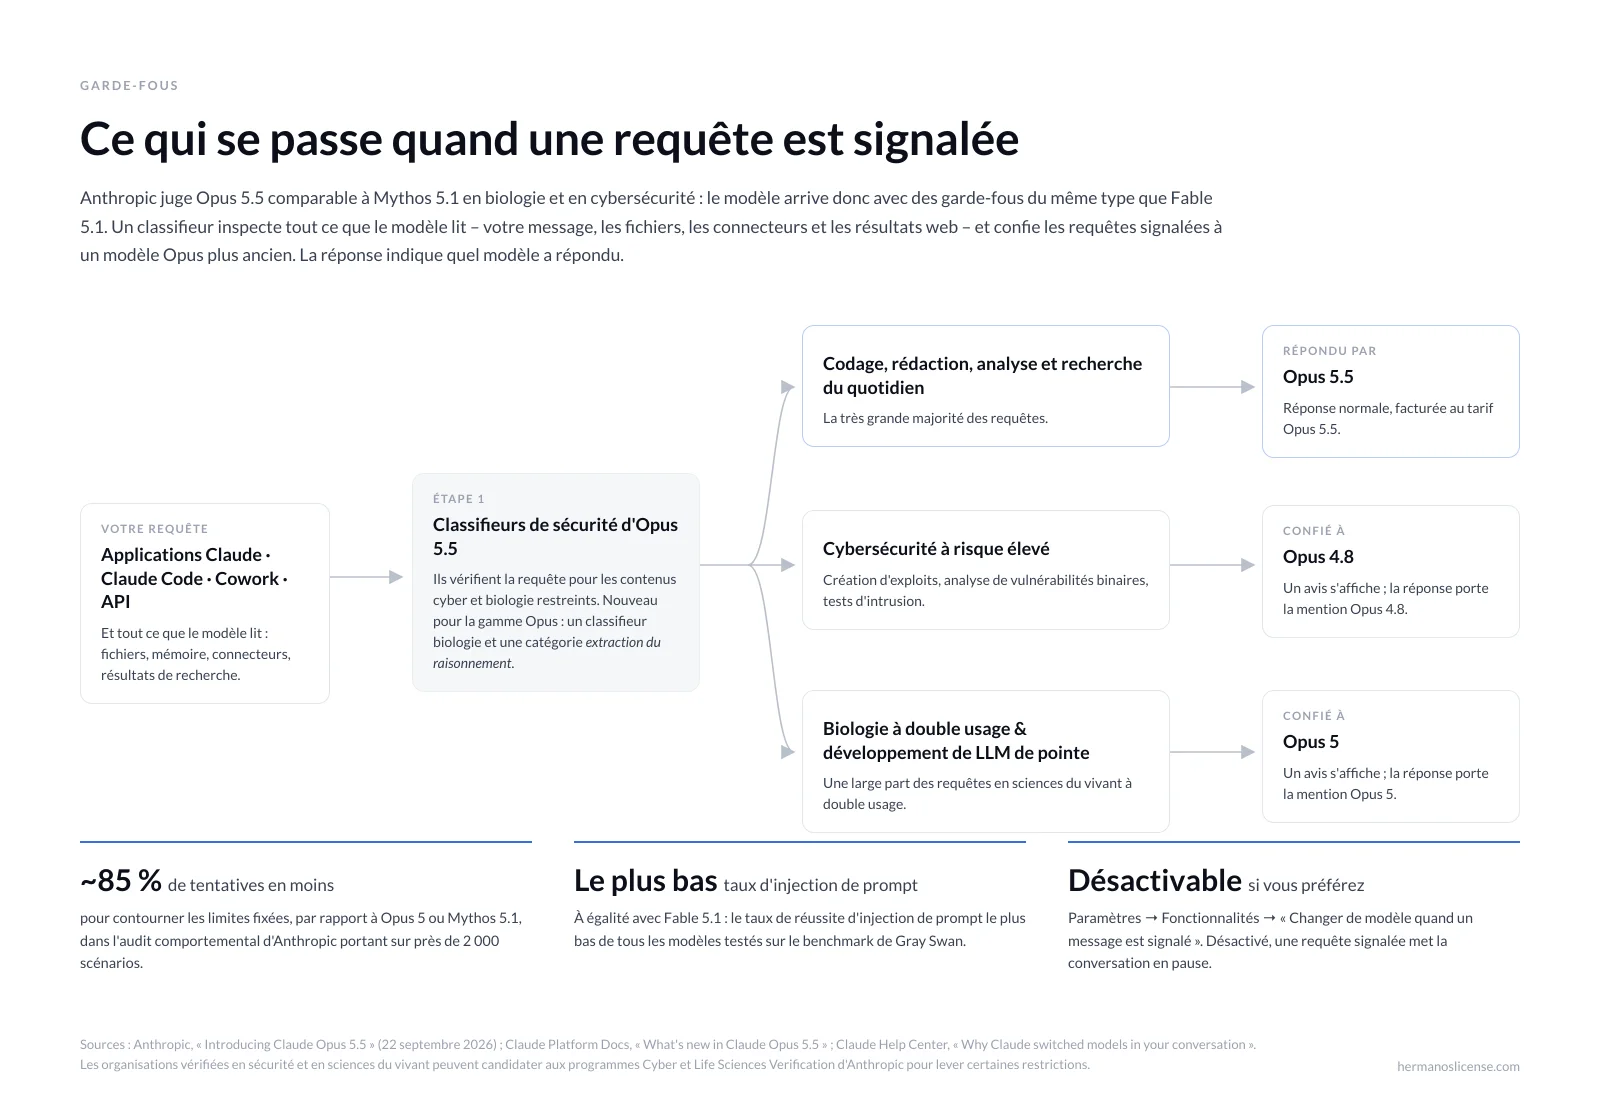
C'est la partie que les utilisateurs d'Opus 5 remarqueront en premier. Comme Anthropic juge Opus 5.5 comparable à Mythos 5.1 en biologie et en cybersécurité, le modèle arrive avec « une catégorie de garde-fous semblable à celle de Fable 5.1 » sur la cybersécurité, la biologie et la distillation, plutôt qu'avec le jeu plus léger d'Opus 5. Un classifieur surveille chaque requête, y compris les fichiers joints, la mémoire, le contenu des connecteurs et les résultats web – pas seulement votre dernier message. S'il signale une requête de cybersécurité à risque élevé, la conversation est confiée à Opus 4.8 ; s'il signale une requête de biologie à double usage ou de développement de LLM de pointe, elle va à Opus 5, un aiguillage nouveau pour la gamme Opus, puisqu'Opus 5 lui-même ne basculait jamais sur la biologie. Un avis vous signale le changement de modèle et la réponse porte la mention du modèle qui a répondu. L'article du centre d'aide sur le changement de modèle pour Opus 5 décrit les réglages de l'application, qui restent valables : vous pouvez désactiver la bascule automatique dans Paramètres → Fonctionnalités (« Changer de modèle quand un message est signalé ») ; désactivée, une requête signalée met la conversation en pause au lieu de changer de modèle, et modifier votre message précédent avant de réessayer suffit souvent.
Côté API, le tableau est un peu différent : une requête refusée renvoie un HTTP 200 normal avec stop_reason: "refusal" et un objet stop_details nommant le domaine de politique concerné ; une option bêta fallbacks: "default" relance la requête côté serveur sur le modèle recommandé par Anthropic. Deux catégories de garde-fous sont nouvelles pour la gamme Opus : un classifieur de sécurité biologie et une catégorie reasoning_extraction pour les requêtes qui cherchent à faire reproduire au modèle son raisonnement interne.
| Si votre requête relève de… | Qui répond | Ce que vous voyez |
|---|---|---|
| Codage, rédaction, analyse et recherche du quotidien (la très grande majorité) | Opus 5.5 | Une réponse normale |
| Cybersécurité à risque élevé : création d'exploits, analyse de vulnérabilités binaires, tests d'intrusion | Opus 4.8 | Un avis de changement de modèle ; réponse portant la mention Opus 4.8 |
| Biologie à double usage ou développement de LLM de pointe | Opus 5 | Un avis de changement de modèle ; réponse portant la mention Opus 5 |
| L'un des deux cas ci-dessus, bascule automatique désactivée | Personne pour l'instant | La conversation se met en pause ; modifiez et réessayez, ou réactivez la bascule |
Anthropic n'a pas publié pour Opus 5.5 de pourcentages de réduction des fausses alertes comme il l'avait fait pour Fable 5.1 : considérez donc le taux d'intervention comme « comparable à Fable 5.1 » jusqu'à indication contraire. Ce qui a été publié, en revanche, c'est un moyen de contourner l'aiguillage : le Cyber Verification Program sera élargi « dans les prochaines semaines » afin que les professionnels de la sécurité vérifiés puissent utiliser Opus 5.5 pour des travaux de sécurité offensive, et le Life Sciences Verification Program accepte les candidatures des organisations menant des travaux de biologie avancée.
Côté alignement, Anthropic indique qu'Opus 5.5 a obtenu de meilleurs résultats que tout modèle Claude récent sur presque toutes les mesures de comportement désaligné de son audit comportemental automatisé, soit près de 2 000 scénarios couvrant des raisonnements biaisés, des tentatives d'évasion d'un bac à sable ou des actions nuisibles engagées après avoir conclu que la situation était simulée. Opus 5.5 égale aussi Fable 5.1 pour le taux de réussite d'injection de prompt le plus bas de tous les modèles testés sur le benchmark de Gray Swan, et il égale ou dépasse Opus 5 dans toutes les configurations essayées. L'entreprise ajoute deux réserves honnêtes : détecter chaque défaillance avant déploiement « reste un problème non résolu », et le modèle soupçonne souvent qu'il est en cours d'évaluation, ce qui complique la mesure de son comportement réel.
Raisonnement protégé, filigrane et « rythmer la frontière »
Trois éléments de politique héritent de Fable 5.1. Le raisonnement protégé (preserved thinking), la mesure anti-distillation d'Anthropic, s'applique désormais à Opus 5.5 : les comptes API créés à partir du 31 août 2026 ne peuvent plus modifier le contexte antérieur du modèle pour en extraire le raisonnement, et les blocs de raisonnement sont liés au préfixe de conversation qui les a produits. Le rapport de renseignement sur les menaces d'Anthropic de septembre 2026 décrit le type d'attaque visé : des milliers de faux comptes utilisés pour extraire les capacités d'un modèle à l'échelle industrielle. Le filigrane du texte généré, introduit avec Fable 5.1 pour répondre aux obligations de transparence du règlement européen sur l'IA, est également actif sur Opus 5.5. Et la conservation zéro des données reste disponible, comme sur les modèles Opus précédents.
Le cadrage retenu par Anthropic mérite d'être noté. Opus 5.5 est « notre premier modèle depuis que nous avons appelé à rythmer la frontière », position défendue par le PDG Dario Amodei selon laquelle le progrès doit être cadencé de manière à ce que les pratiques de sécurité restent en avance sur les capacités. Concrètement, cela s'est traduit par des tests externes menés par METR et Frontier Design avant la sortie, des garde-fous calibrés sur le risque mesuré, et une version 5.5 plutôt qu'un 6.
Pour les développeurs : ce qui casse en venant d'Opus 5
Changer l'identifiant du modèle ne suffit pas. Le guide de migration d'Anthropic recense quatre ruptures de compatibilité et quelques changements de comportement, qui se manifestent tous par des erreurs 400 ou par des sorties subtilement différentes si vous les ignorez.
| Changement | Ce qui se passe | Que faire |
|---|---|---|
| Le raisonnement ne peut plus être désactivé | thinking.type: "disabled" renvoie une 400 | Supprimez le champ thinking ; réglez la profondeur avec output_config.effort |
| Usage d'outil forcé supprimé | tool_choice valant any ou tool renvoie une 400 | Utilisez auto avec un schéma d'outil strict, ou des sorties structurées |
| Blocs de raisonnement liés au modèle et au préfixe | Opus 5.5 ne lit pas le raisonnement de Fable ou de Mythos ; un prompt système, des outils ou des messages antérieurs modifiés renvoient une 400 par défaut | Utilisez l'en-tête bêta thinking-binding-controls-2026-08-01 avec prefix_mismatch_behavior: "drop_block" pour écarter les blocs concernés |
| Nouvel outil d'usage de l'ordinateur | computer_20251124 n'est pas pris en charge sur l'API Claude ni sur Google Cloud | Passez à computer_toolset_20260801 (Bedrock accepte encore l'ancien outil) |
| L'effort par défaut est Medium | C'était High sur Opus 5 | Refaites vos balayages d'effort ; réglez-le explicitement si vous comptiez sur High |
| Les textes d'avancement vivent dans les blocs de raisonnement | Le texte entre deux appels d'outils est omis par défaut (thinking.display: "omitted") | Utilisez thinking.display: "updates" avec l'en-tête bêta thinking-display-updates-2026-08-18 si vous diffusez des messages d'état |
Le mode Fast s'active avec speed: "fast" sous l'en-tête bêta fast-mode-2026-02-01 et n'existe que sur l'API Claude ; Bedrock, Vertex AI et Foundry ne le proposent pas. La mise en cache des prompts exige au moins 512 tokens pour créer une entrée de cache.
Quel forfait Claude inclut Opus 5.5 ?
L'annonce est précise sur trois points et muette sur le reste. Elle indique qu'Anthropic relève les limites d'usage sur cinq heures pour les forfaits Pro, Max, Team et Enterprise par siège – ce qui revient à dire que le modèle est disponible sur ces forfaits – et elle introduit pour les abonnés une réinitialisation de limite que « vous pouvez désormais conserver et utiliser quand vous le souhaitez », autrement dit une réinitialisation stockée que vous déclenchez lorsqu'une limite de session tombe au mauvais moment. Elle ne donne pas de pourcentage pour la hausse des limites, ne mentionne pas le forfait Free et ne dit pas si Opus 5.5 remplace Opus 5 comme modèle par défaut. Pour mémoire, Opus 5 est arrivé le 24 juillet comme modèle par défaut sur Max et modèle le plus puissant sur Pro ; si Anthropic suit le même schéma, Opus 5.5 reprend ces places – mais vérifiez dans le sélecteur de modèle plutôt que de le supposer.
| Forfait | Opus 5.5 | Ce que dit l'annonce |
|---|---|---|
| Free | Non précisé | L'annonce ne mentionne pas le forfait Free |
| Pro | Oui | Limites sur cinq heures relevées ; réinitialisation de limite conservable |
| Max 5x et Max 20x | Oui | Limites sur cinq heures relevées ; réinitialisation de limite conservable |
| Team | Oui | Limites sur cinq heures relevées ; réinitialisation de limite conservable |
| Enterprise (par siège) | Oui | Limites sur cinq heures relevées ; conservation zéro des données disponible |
| Claude Code | Oui | Inclus avec le mode Fast ; mettez à jour vers la version courante |
| API Claude / Bedrock / Vertex AI / Foundry | Oui | claude-opus-5-5 aux tarifs ci-dessus |
Quel forfait choisir ? L'équation a changé sur un point précis. Fable 5.1 est plafonné à 50 % de votre limite hebdomadaire sur un forfait Max et facturé en crédits sur Pro : un usage intensif de Fable pousse donc à monter en gamme. Opus 5.5 est un modèle Opus ordinaire avec des limites ordinaires, et ces limites viennent d'augmenter, tandis que le modèle dépense moins de tokens par travail. Si Fable 5.1 était votre seule raison d'envisager Max, essayez d'abord Opus 5.5 sur Pro pour le codage et la rédaction du quotidien ; gardez Fable pour les problèmes où Opus en High ou X-High passe encore à côté de quelque chose. Si vous enchaînez des sessions Claude Code de plusieurs heures ou plusieurs agents à la fois, les niveaux Max restent conçus pour cela, et Max 20x demeure l'option offrant la plus grande capacité de session.
Où Hermanos License entre en jeu
Notre catégorie Outils IA regroupe les abonnements d'assistants que nous vendons, avec livraison numérique par e-mail et dans votre tableau de bord, et 15 jours d'assistance boutique sur chaque commande. La disponibilité évolue : chaque fiche produit affiche le stock, le prix et les modalités de livraison en direct. À l'heure où nous écrivons, la catégorie comprend :
| Produit | Ce que vous obtenez | En quoi cela sert avec Opus 5.5 |
|---|---|---|
| Abonnement Claude Max 20x | Le niveau grand public le plus élevé d'Anthropic, avec Opus 5.5 et Fable 5.1 (Fable jusqu'à 50 % des limites hebdomadaires), accès complet à Claude Code et Cowork | Longues sessions Claude Code, plusieurs agents en parallèle et passage d'Opus 5.5 à Fable 5.1 sans crédits |
| Google AI Pro (Gemini) – abonnement 18 mois | Le niveau payant de Gemini pendant 18 mois, livré sous forme de lien d'activation | Un second assistant pour la recherche et le recoupement des réponses de Claude ; intégration à Google Workspace |
| Google AI Pro – Gemini Advanced + 5 To de stockage | Gemini Advanced plus 5 To de stockage Google | De l'espace pour les documents, jeux de données et dépôts que vous confiez à de longues sessions d'agents |
De nouveaux abonnements IA rejoignent cette catégorie dès que les fournisseurs les référencent : consultez plutôt la page de catégorie que ce tableau.
Opus 5.5 donne le meilleur de lui-même à l'intérieur des logiciels que vous possédez déjà, et les associations du guide Fable 5.1 restent valables :
| Si vous utilisez Opus 5.5 pour… | À associer avec | À trouver dans |
|---|---|---|
| Le codage et les sessions Claude Code | Windows 11 Pro pour une vraie machine de développement locale : Hyper-V, Windows Sandbox, BitLocker, hébergement Bureau à distance | Windows 11 |
| Les présentations, rapports et analyses financières | Microsoft Office, pour que les fichiers .pptx et .xlsx produits s'ouvrent exactement comme prévu | Licences Office |
| Les schémas de processus et plannings de projet | Microsoft Visio et Project : Opus dessine, vous affinez | Visio & Project |
| Le travail de design et les prototypes d'interface | CorelDRAW ou Figma pour finaliser les maquettes du modèle | Outils de design |
| La lecture de PDF, contrats et scans | Adobe Acrobat Pro pour modifier et signer ce que le modèle résume | Adobe Acrobat Pro 2020 |
| Les agents qui naviguent sur le web à votre place | Une protection des postes et un VPN, car les agents ouvrent des pages que vous ne voyez jamais | Antivirus & VPN |
| Les audits SEO et plans de contenu | Screaming Frog SEO Spider pour les données de crawl que le modèle analyse | Screaming Frog SEO Spider |
Toutes les licences et tous les abonnements Hermanos License sont livrés numériquement. Les abonnements Claude restent soumis aux conditions grand public d'Anthropic, limites de session et limites hebdomadaires comprises.
Questions fréquentes
Opus 5.5 est-il meilleur que Fable 5.1 ?
Dans le tableau publié par Anthropic, il devance Fable 5.1 sur chaque benchmark listé, à 40 % du prix au token. La formulation d'Anthropic est plus prudente : le modèle « se situe au niveau de Claude Fable 5.1 sur la plupart des travaux ». Fable 5.1 reste le haut de la gamme et le modèle vers lequel se tourner quand Opus en effort High ou X-High laisse encore passer une condition.
Pourquoi une version 5.5 et pas Claude 6 ?
L'entreprise présente Opus 5.5 comme sa première sortie depuis son appel à « rythmer la frontière » : améliorer l'efficacité, l'alignement et les garde-fous d'un modèle dont elle estime largement comprendre les risques, plutôt que réaliser un saut de capacité plus large. Sonnet 5.5 et Haiku 5.5 suivront dans les prochaines semaines « avec une grande partie des mêmes améliorations de performance, d'efficacité et de sécurité ».
Puis-je utiliser Opus 5.5 avec le forfait Free ?
L'annonce cite Pro, Max, Team et Enterprise par siège, et ne mentionne pas Free. La réponse définitive se trouve dans le sélecteur de modèle de votre compte.
Pourquoi ma conversation Opus 5.5 est-elle passée à Opus 4.8 ou Opus 5 ?
Un classifieur de sécurité a signalé la requête comme relevant de la cybersécurité à risque élevé (traitée par Opus 4.8) ou de la biologie à double usage et du développement de LLM de pointe (traité par Opus 5). La réponse porte la mention du modèle qui a répondu. Les utilisateurs d'Opus 5 ne connaissaient pas l'aiguillage biologie : il est nouveau avec Opus 5.5, parce que la capacité du modèle en biologie est jugée comparable à celle de Mythos 5.1.
Opus 5.5 est-il vraiment 40 % moins cher ? Le prix catalogue n'a baissé que de 20 %.
Les deux sont vrais. Le prix au token a baissé de 20 % (60 % pour les lectures de cache). Le chiffre de « 40 % de moins à faire tourner » est l'estimation d'Anthropic pour des charges classiques et intègre le fait que le modèle termine les tâches en moins d'étapes et de tokens ; les retours clients faisant état d'un tiers à une moitié des tokens vont dans ce sens, mais votre charge de travail atterrira quelque part de précis.
Puis-je couper le raisonnement pour économiser ?
Non. Le raisonnement adaptatif est toujours actif sur Opus 5.5 et l'API renvoie une erreur si vous tentez de le désactiver. Utilisez plutôt le paramètre d'effort : c'est en Low que se fait l'économie, et plusieurs testeurs rapportent qu'il égale Opus 5 en High.
Qu'est-ce que la « réinitialisation de limite » ?
Une remise à zéro de votre limite d'usage de session que les abonnés peuvent désormais conserver et déclencher au moment de leur choix, au lieu d'attendre le renouvellement de la fenêtre de cinq heures. Anthropic l'a introduite en même temps que le relèvement des limites sur cinq heures pour Pro, Max et Team.
Sources
Anthropic, « Introducing Claude Opus 5.5 » (22 septembre 2026) · Claude Platform Docs, « What's new in Claude Opus 5.5 » et « Models overview » (identifiants de modèles, fenêtre de contexte, limites de sortie, effort par défaut, ruptures de compatibilité) · Claude Platform Docs, « Pricing » (tarifs catalogue, cache, batch, mode Fast et résidence des données) · Claude Platform Docs, page du modèle « Claude Opus 5 » (tarifs et date de sortie d'Opus 5) · Claude Help Center, « Why Claude switched models in your conversation » (aiguillage, mentions, réglage) · Claude Help Center, notes de version (22 septembre 2026) · Anthropic, « Introducing Claude Opus 5 » (24 juillet 2026). Les chiffres de benchmarks et les citations clients sont les données publiées par Anthropic et n'ont pas été vérifiées de façon indépendante.