Claude Fable 5.1 erklärt: Was neu ist, was es kostet und welche Claude-Tarife es enthalten
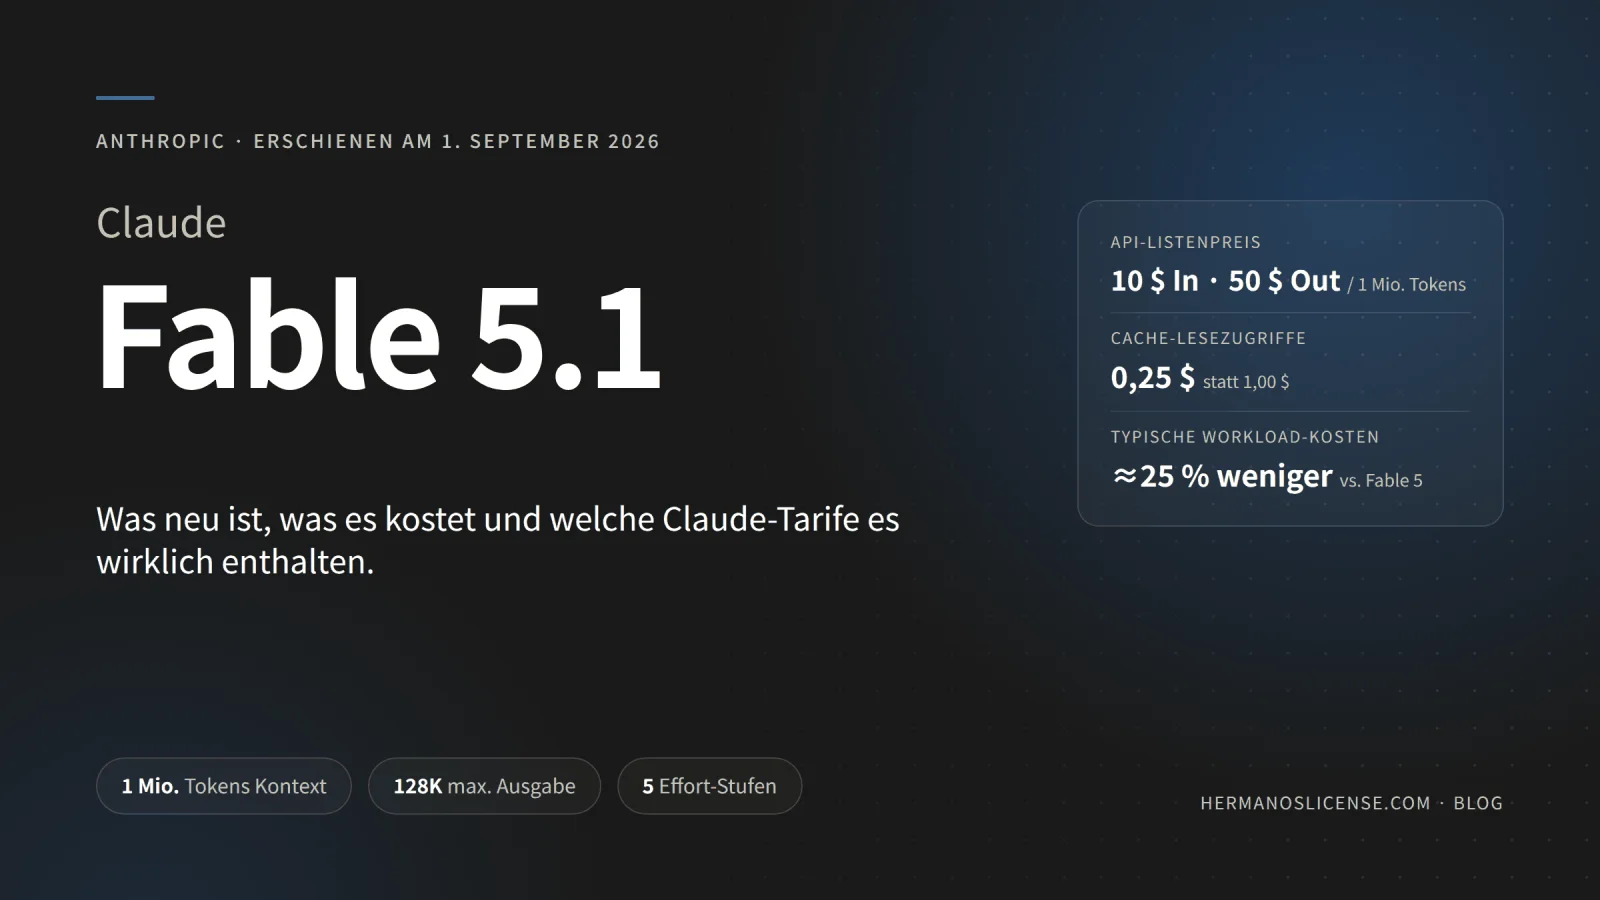
Am 1. September 2026 hat Anthropic Claude Fable 5.1 veröffentlicht, den Nachfolger des im Juni gestarteten Fable 5. Die Kernbotschaft ist für ein Frontier-Modell ungewöhnlich: Der Listenpreis ist nicht gestiegen, das Modell ist bei langen, werkzeugintensiven Aufgaben messbar besser geworden, und die Sicherheitsfilter, die manche Fable-5-Nutzer frustriert haben, greifen jetzt deutlich seltener ein. In der Ankündigung taucht außerdem ein zweiter Name auf: Claude Mythos 5.1 – dasselbe Modell mit weniger Leitplanken, vorbehalten für geprüfte Organisationen.
Dieser Leitfaden erklärt, was sich tatsächlich geändert hat – mit den Zahlen, die Anthropic veröffentlicht hat –, was das Modell über die API kostet, welche Claude-Abos es enthalten und wo es neben den Tools, die Sie vielleicht schon im Einsatz haben, seinen Platz findet. Das Marketing haben wir draußen gelassen, die Zahlen drin.
Fable 5.1 auf einen Blick
| Merkmal | Claude Fable 5.1 |
|---|---|
| Veröffentlichung | 1. September 2026 |
| API-Modell-ID | claude-fable-5-1 |
| Kontextfenster / max. Ausgabe | 1.000.000 Tokens / 128.000 Tokens |
| Verlässlicher Wissensstand | Juni 2026 |
| Effort-Stufen | Low · Medium · High · X-High · Max |
| API-Listenpreis | 10 US-Dollar (USD) pro Million Input-Tokens · 50 $ pro Million Output-Tokens · 0,25 $ pro Million Tokens bei Cache-Lesezugriffen |
| Claude-Tarife | In Max und Team Premium enthalten (bis zu 50 % der Wochenlimits); Nutzungsguthaben in Pro und Team Standard; nicht in Free |
| Verfügbar über | Claude.ai, Claude Code, Claude Cowork, Claude API, Amazon Bedrock, Google Vertex AI, Microsoft Foundry |
| Schwestermodell | Claude Mythos 5.1 – identische Gewichte, schwächere Schutzmechanismen, nur per Trusted Access (vorerst nur US-Organisationen) |
Zuerst der Stammbaum: Fable, Mythos und Opus
Anthropics Namensschema kann verwirren, deshalb lohnt sich ein kurzer Blick darauf. Jahrelang lautete die Reihenfolge Haiku, Sonnet, Opus – klein, mittel, groß. 2026 kam oberhalb von Opus eine neue Stufe hinzu, die Anthropic als Mythos-Klasse bezeichnet. Die Variante mit uneingeschränkten Fähigkeiten, Mythos, steht nur zugelassenen Organisationen über Trusted-Access-Programme zur Verfügung, weil ihre Fähigkeiten in Cybersicherheit und Biologie als zu heikel für eine offene Freigabe gelten. Fable ist dasselbe Modell, umgeben von klassifikatorbasierten Schutzmechanismen, damit es an alle verkauft werden kann.
Die beiden sind keine „ähnlichen“ Modelle: Anthropic sagt unmissverständlich, dass Fable 5.1 und Mythos 5.1 dasselbe Modell mit unterschiedlich strengen Schutzmechanismen sind. Löst eine Fable-Anfrage einen Schutzmechanismus aus, wird sie stattdessen an ein Opus-Modell übergeben – deshalb liegen die veröffentlichten Benchmark-Werte von Fable bei Aufgaben mit Bezug zu Security-Tooling etwas unter denen von Mythos. Dazu weiter unten mehr.
| Modell | Wer es nutzen kann | Wofür es gedacht ist | API-Preis (Input / Output, pro 1 Mio. Tokens) |
|---|---|---|---|
| Claude Mythos 5.1 | Zugelassene Organisationen in Anthropics Trusted-Access-Programmen; zum Start nur mit Sitz in den USA | Defensive Sicherheitsforschung, professionelle F&E in den Life Sciences | 10 $ / 50 $ |
| Claude Fable 5.1 | Alle mit einem kostenpflichtigen Claude-Tarif oder API-Zugang | Die schwierigsten Coding-, Recherche- und Wissensarbeitsaufgaben; lange unbeaufsichtigte Agentenläufe | 10 $ / 50 $ |
| Claude Opus 5 | Alle kostenpflichtigen Tarife und die API | Starkes Allzweckmodell; zugleich Ausweichmodell für Biologie-Anfragen, die Fables Schutzmechanismen umleiten (Cyber-Umleitungen übernimmt Opus 4.8) | 5 $ / 25 $ |
| Claude Sonnet 5 | Breit verfügbar in Claude-Tarifen und der API | Schneller Alltagsassistent und Automatisierung mit hohem Volumen | 2 $ / 10 $ |
Was ist neu in Fable 5.1?
Mehr Leistung pro Token: der Effort-Regler
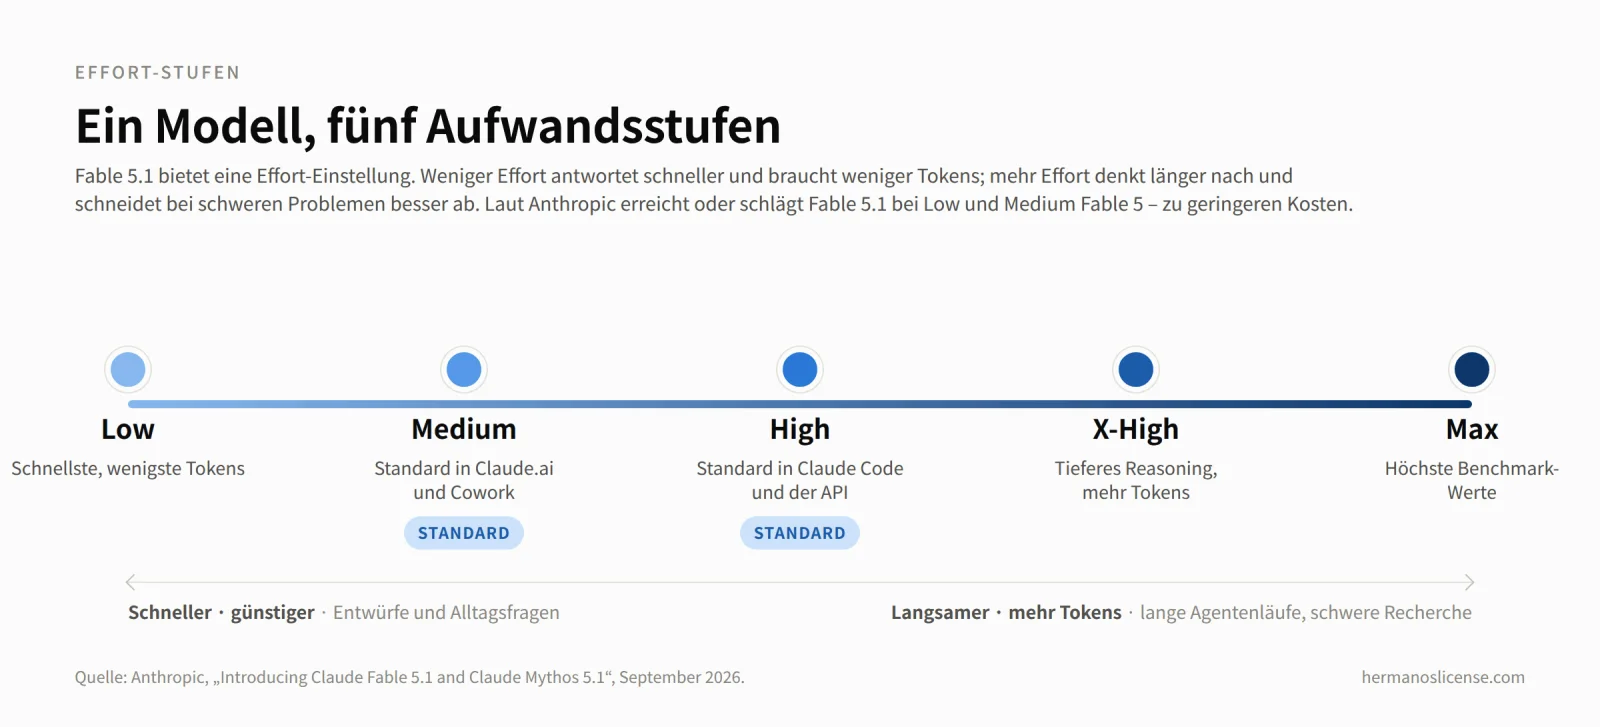
Die in der Praxis wichtigste Änderung ist kein einzelner Benchmark, sondern die Art, wie das Modell Rechenleistung einsetzt. Fable 5.1 bietet fünf Effort-Stufen (Aufwandsstufen). Bei Low und Medium erreicht das neue Modell laut Anthropic „ähnliche oder bessere Ergebnisse als Fable 5“ – zu deutlich geringeren Kosten; hier entsteht der größte Teil der Ersparnis im Alltag. Bei High, X-High und Max denkt es länger nach und setzt sich bei schwierigen Problemen klar von seinem Vorgänger ab.
Im normalen Gebrauch müssen Sie daran nichts ändern. Claude.ai und Claude Cowork stehen standardmäßig auf Medium, Claude Code und die API auf High. Entwickler und Power-User können den Regler für ein schwieriges Refactoring oder einen Recherchelauf hochdrehen – und für Entwürfe und schnelle Fragen herunter.
Die Benchmarks im Überblick
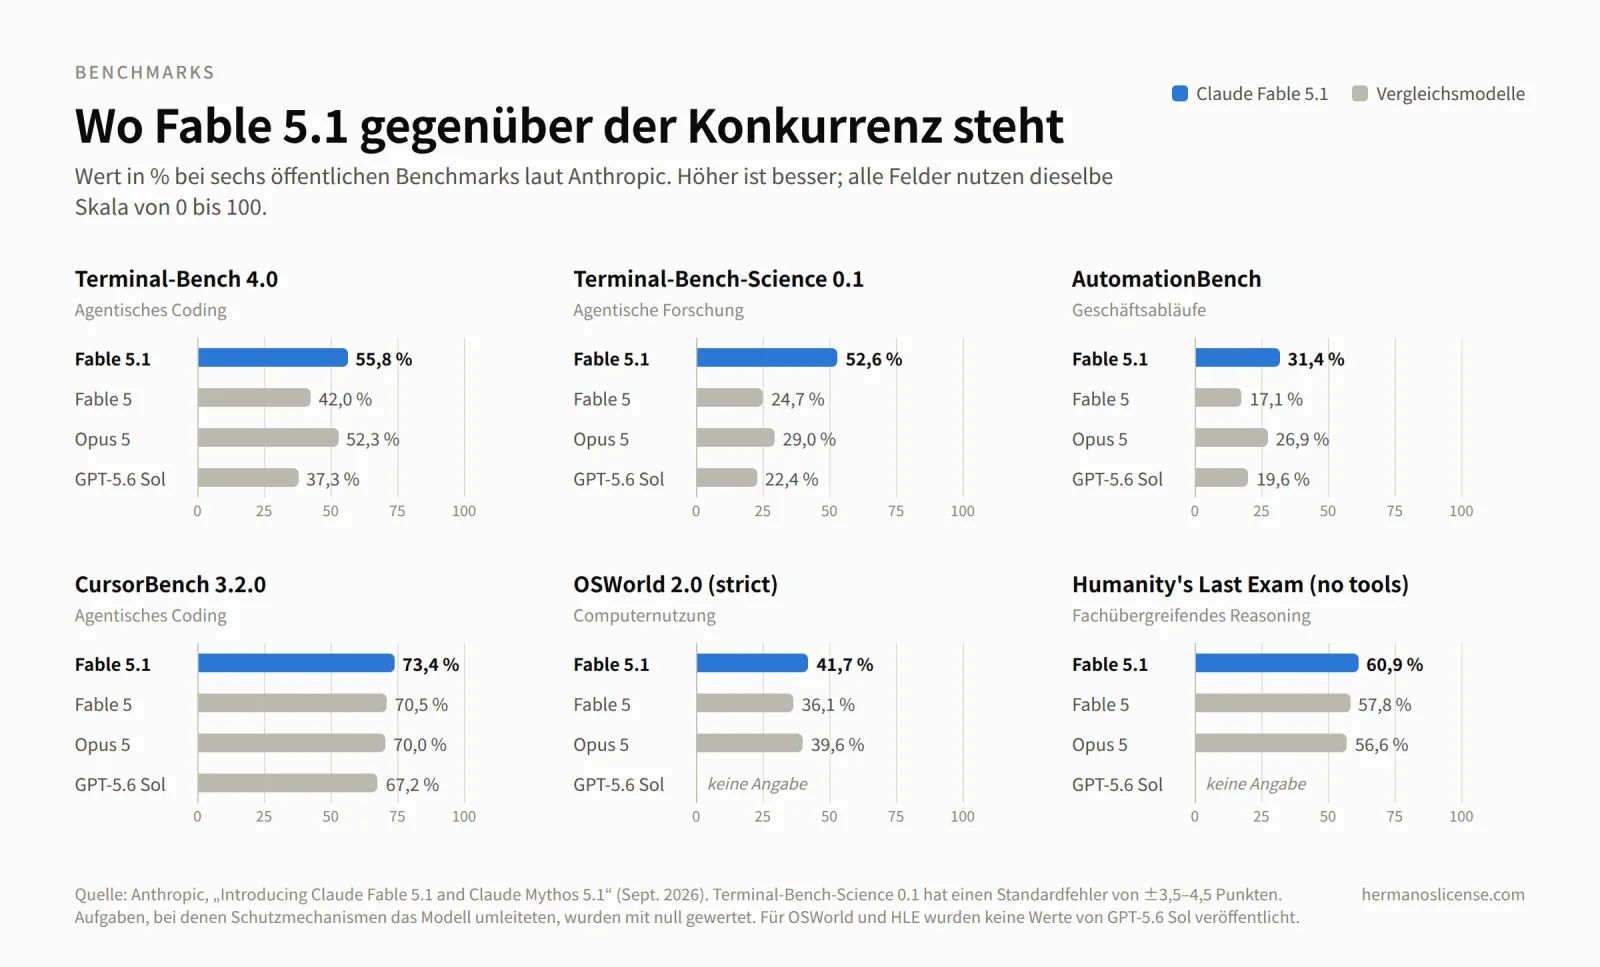
Anthropic hat einen Vergleich mit Fable 5, Opus 5 und GPT-5.6 Sol von OpenAI veröffentlicht. Die größten Sprünge zeigen sich bei Benchmarks, die anhaltende, mehrstufige Arbeit im Terminal oder im Browser belohnen statt einer einzelnen, direkten Antwort. Bei Terminal-Bench-Science, einem Test für agentische wissenschaftliche Forschung, erreicht Fable 5.1 mehr als das Doppelte des Fable-5-Werts. Bei AutomationBench, das Geschäftsabläufe simuliert, ist es knapp das Doppelte. Die Zuwächse bei reinen Reasoning-Tests wie Humanity's Last Exam sind real, aber kleiner.
| Benchmark | Was gemessen wird | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Agentisches Coding | 55,8 % | 42,0 % | 52,3 % | 37,3 % |
| Terminal-Bench-Science 0.1 | Agentische wissenschaftliche Forschung | 52,6 % | 24,7 % | 29,0 % | 22,4 % |
| CursorBench 3.2.0 | Agentisches Coding (Effort-Stufe Max) | 73,4 % | 70,5 % | 70,0 % | 67,2 % |
| AutomationBench | Geschäftsabläufe | 31,4 % | 17,1 % | 26,9 % | 19,6 % |
| OSWorld 2.0 (strikt) | Computernutzung | 41,7 % | 36,1 % | 39,6 % | – |
| OSWorld 2.0 (mit Teilpunkten) | Computernutzung | 77,9 % | 72,9 % | 75,4 % | – |
| Humanity's Last Exam (ohne Tools) | Fachübergreifendes Reasoning | 60,9 % | 57,8 % | 56,6 % | – |
| Humanity's Last Exam (mit Tools) | Fachübergreifendes Reasoning | 65,0 % | 63,8 % | 63,6 % | – |
| GDPval-AA v2 | Wissensarbeit (Rating, kein %) | 1853 | 1723 | 1824 | 1711 |
Quelle: Launch-Ankündigung von Anthropic, September 2026. Terminal-Bench-Science 0.1 hat einen Standardfehler von etwa ±3,5–4,5 Punkten; kleine Abstände sollten Sie dort mit Vorsicht lesen. Anthropic weist außerdem darauf hin, dass Aufgaben, bei denen Schutzmechanismen das Modell zu Opus umgeleitet haben, mit null Punkten gewertet wurden – das drückt Fables Werte gegenüber Mythos 5.1 leicht (60,9 % bei Terminal-Bench 4.0 gegenüber 55,8 % bei Fable).
Gebaut für Arbeit, die Stunden dauert, nicht Minuten
Benchmarks beiseite: Das Motiv, das sich durch die von Anthropic zitierten Kundenstimmen zieht, ist Ausdauer. MongoDB beschreibt, wie das Modell stundenlang unbeaufsichtigt mit Verifikationsschleifen lief, man morgens die nächste Phase fertig vorfand und ein komplexer Prototyp in drei Tagen stand. Ramp berichtet von einem 38-stündigen unbeaufsichtigten Machine-Learning-Lauf, in dem das Modell ein früheres Ergebnis als Labeling-Artefakt entlarvte, sechs parallele Experimente startete und mit einem Resultat samt nächsten Schritten zurückkam. Browserbase hat die Abschlussquote seiner schwierigsten Browser-Agent-Aufgaben – jeweils rund zehn Minuten lang – gemessen: 82 % bei Fable 5.1 gegenüber 74 % bei Opus 5 und 57 % bei Fable 5, bei geringerem Token-Verbrauch.
Ein Entwickler von Shopify beschreibt den qualitativen Unterschied treffend: ein Modell, das eigene Notizen führt, Prioritäten neu ordnet und dort weitermacht, wo es aufgehört hat, ohne die Richtung zu verlieren. Genau diese Fähigkeit verkauft Anthropic mit 5.1 eigentlich: keinen klügeren Chatbot, sondern einen Agenten, dem Sie einen mehrstündigen Auftrag übergeben können. Für Nutzer von Claude Code ist das besonders relevant – dort steht der Effort standardmäßig ohnehin auf High, und das Modell soll sich eigenständig durch eine Codebasis arbeiten.
Schreiben, Recherche und alltägliche Wissensarbeit
Nicht jeder Käufer ist Entwickler, und die Fortschritte von 5.1 beschränken sich nicht auf Code. Glean hat Blindvergleiche bei alltäglicher Wissensarbeit durchgeführt – Recherche, Textentwürfe, zielgerichtete Fragen – und berichtet, dass die Bewerter die Antworten von Fable 5.1 im Verhältnis zwei zu eins gegenüber Fable 5 bevorzugten. Canva zufolge sind die Texte verständlicher und gehaltvoller, halten sich besser an Vorgaben und schlugen Fable 5 in Blindtests. Hebbia, dessen Nutzer mit Finanzdokumenten arbeiten, nennt die erzeugten PowerPoint-Präsentationen die besten aller getesteten Modelle, mit der besten Faktentreue bei Quellenangaben. Bei GDPval-AA v2, einer Bewertung realer beruflicher Aufgaben durch Dritte, erreicht Fable 5.1 einen Wert von 1853 gegenüber 1723 für Fable 5.
Ein Blick auf den Forschungseinsatz
Anthropic hat den Launch genutzt, um zu zeigen, was das Modell leistet, wenn man es auf offene wissenschaftliche Fragen ansetzt. Drei Beispiele stechen heraus. Beim Design von Protein-Bindern erreichte das Modell eine Erfolgsquote von „knapp 50 % über 12 Zielstrukturen“, wo 10–15 % üblich sind, und erzeugte bei drei Zielen Binder mit etwa zehnfacher Affinität gegenüber den besten Wettbewerbsbeiträgen. Aus dreißig Jahre alten Radardaten der NASA-Sonde Magellan erstellte es eine Höhenkarte für ein Drittel der Venus mit einer Auflösung von zwei bis drei Kilometern – frühere Karten kamen auf zehn bis zwanzig –, veröffentlicht unter einer Creative-Commons-Lizenz. Und es schrieb die GPU-Kernel von sieben Open-Source-Modellen aus Proteinforschung und Genomik neu und beschleunigte sie auf NVIDIA-H100-GPUs um das 1,4- bis 2,5-Fache – Arbeit, die laut Anthropic Tage statt der üblichen Wochen dauerte.
Beachten Sie: Die fortgeschrittenen Biologie-Arbeiten laufen mit Zugang auf Mythos-Niveau über das Life Sciences Verification Program (Verifizierungsprogramm für die Life Sciences), nicht über das öffentliche Fable 5.1, das seine Biologie-Schutzmechanismen behält.
Preise: Was sich geändert hat – und was nicht
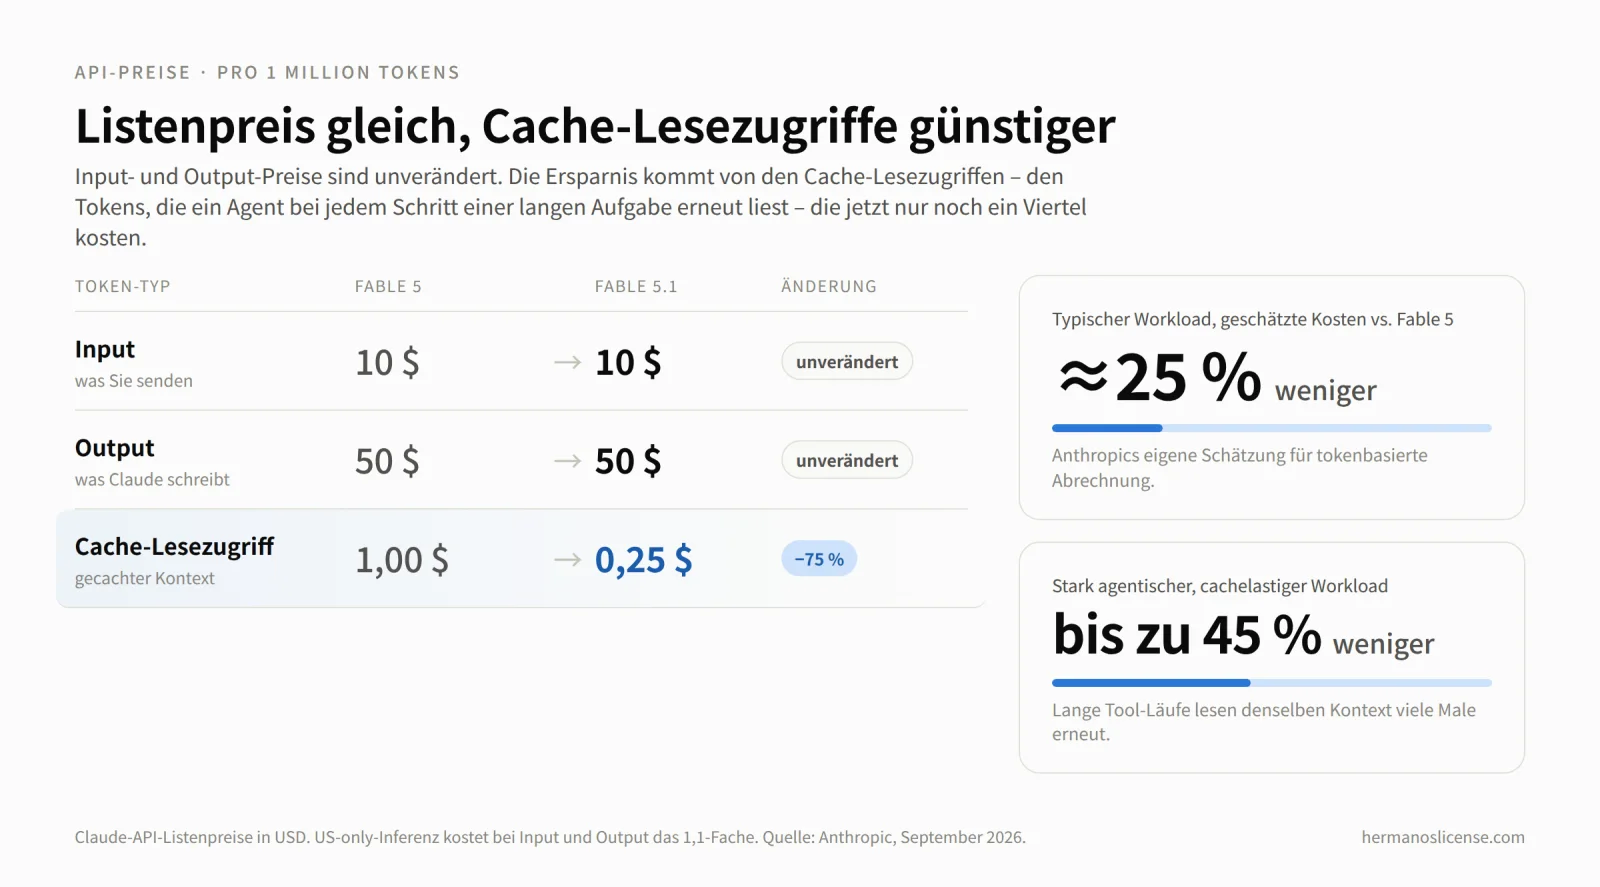
Über die API kostet Fable 5.1 pro Token exakt so viel wie Fable 5: 10 $ pro Million Input-Tokens und 50 $ pro Million Output-Tokens. Geändert haben sich die Cache-Lesezugriffe: Ihr Preis fiel von 1,00 $ auf 0,25 $ pro Million Tokens, ein Abschlag von 75 %.
Falls Ihnen der Begriff neu ist: Wenn Claude an einer langen Aufgabe arbeitet, liest es in jedem Schritt dieselben Anweisungen, Dateien und den bisherigen Gesprächsverlauf erneut ein. Prompt-Caching erlaubt es der API, diesen wiederkehrenden Kontext zwischenzuspeichern und dafür statt des vollen Input-Preises einen reduzierten Satz für „Cache-Lesezugriffe“ zu berechnen. Bei einem Agenten mit Hunderten von Schritten dominieren die gecachten Tokens die Rechnung. Deshalb schätzt Anthropic die effektiven Kosten von Fable 5.1 bei typischen Workloads auf rund 25 % niedriger als bei Fable 5 und bei stark agentischen Workloads auf bis zu 45 % niedriger – obwohl der Listenpreis unverändert ist. Mehrere Kunden berichten von zusätzlichen Einsparungen, einfach weil 5.1 Aufgaben mit weniger Tokens erledigt: Every gibt an, mit der Hälfte der Tokens von Opus 5 doppelt so schnell zu sein, und Rogo erreichte die Genauigkeit von Fable 5 in seinem Finanz-Benchmark mit 20 % weniger Tokens.
| Pro 1 Mio. Tokens | Fable 5 | Fable 5.1 | Opus 5 | Sonnet 5 |
|---|---|---|---|---|
| Input | 10,00 $ | 10,00 $ | 5,00 $ | 2,00 $ |
| Output | 50,00 $ | 50,00 $ | 25,00 $ | 10,00 $ |
| Cache-Lesezugriff | 1,00 $ | 0,25 $ | siehe aktuelle API-Preisliste | |
| Geschätzte Kosten vs. Fable 5, typischer Workload | – | ≈ 25 % niedriger | – | |
| Geschätzte Kosten vs. Fable 5, stark agentischer Workload | – | bis zu 45 % niedriger | – | |
API-Listenpreise in USD laut Modelldokumentation und Launch-Ankündigung von Anthropic. Für Inferenz ausschließlich auf US-Servern gilt ein Multiplikator von 1,1× auf Input und Output. Abo-Tarife (Pro, Max, Team) werden monatlich abgerechnet, nicht pro Token; siehe den Tarif-Abschnitt weiter unten.
Schutzmechanismen: weniger Fehlalarme, dieselben roten Linien
Dieser Teil dürfte Fable-5-Nutzer am meisten interessieren. Der Start von Fable 5 im Juni verlief holprig: Am 12. Juni wurde der Zugang auf Anordnung der US-Regierung ausgesetzt, nachdem eine Technik zur Umgehung der Schutzmechanismen bekannt geworden war, und am 1. Juli – nach Aufhebung der Auflagen – mit einem stärkeren Klassifikator wiederhergestellt. Diese Klassifikatoren hielten das Modell sicher, unterbrachen aber auch legitime Arbeit, etwa wenn Entwickler nach Schwachstellen in ihrem eigenen Code fragten oder Menschen einfache Biologie- und Medizinfragen stellten.
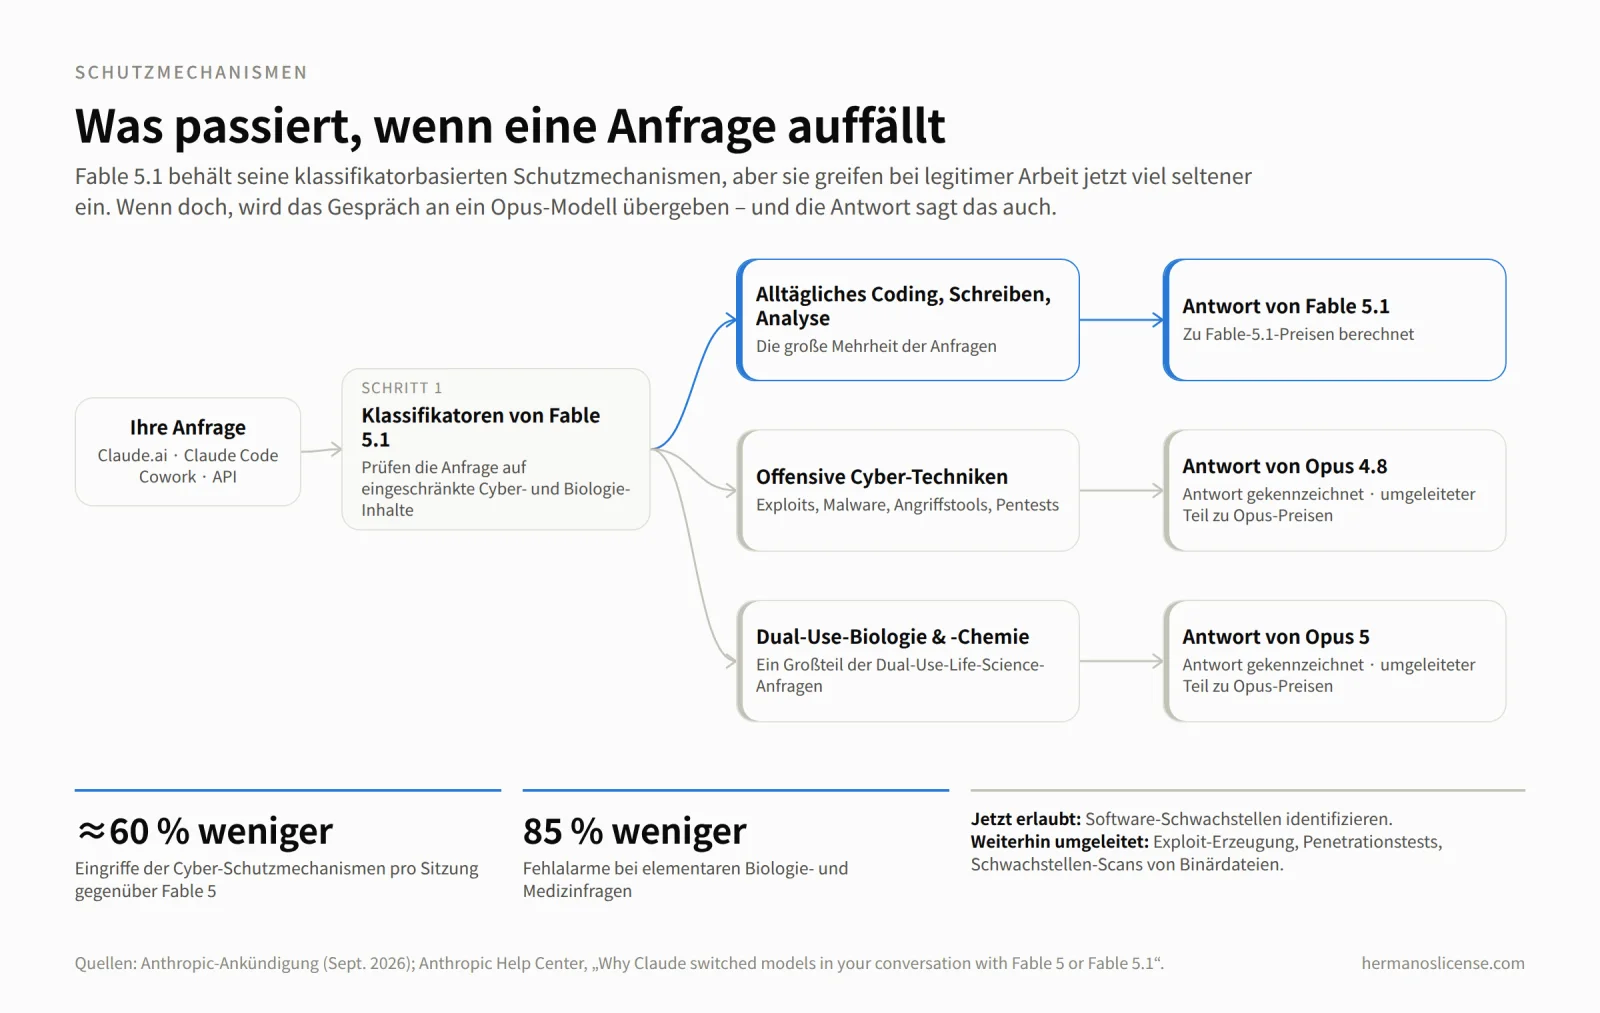
Fable 5.1 behält dieselbe Architektur – ein Klassifikator prüft jede Anfrage, und alles, was auffällt, geht mit einem Hinweis in der Antwort an ein Opus-Modell –, aber die Klassifikatoren sind erheblich präziser. Anthropic meldet rund 60 % weniger Eingriffe der Cyber-Schutzmechanismen pro Sitzung als bei Fable 5 und 85 % weniger Fehlalarme bei elementaren Biologie- und Medizinfragen. Nutzer von Claude Code sehen dieselbe Reduktion der Cybersecurity-Fehlalarme um 60 %. Eine praktische Neuerung: Fable 5.1 darf jetzt Schwachstellen in Software identifizieren, was für Entwickler Routinearbeit ist. Das Erzeugen von Exploits, Penetrationstests und Schwachstellen-Scans von Binärdateien werden weiterhin zu Opus umgeleitet.
| Art der Anfrage | Wer antwortet | Was Sie sehen | Was Sie zahlen |
|---|---|---|---|
| Alltägliches Coding, Schreiben, Analyse, Recherche (die große Mehrheit) | Fable 5.1 | Eine normale Antwort | Fable-5.1-Preise / Tarifkontingent |
| Offensive Cyber-Techniken – Exploits, Malware, Angriffswerkzeuge | Opus 4.8 | Hinweis auf den Modellwechsel; Antwort gekennzeichnet | Opus-Preise für den umgeleiteten Teil (bei Blockierung vor Beginn der Generierung nur Opus-Preise) |
| Dual-Use-Anfragen zu Biologie, Chemie oder Life Sciences | Opus 5 | Hinweis auf den Modellwechsel; Antwort gekennzeichnet | Opus-Preise für den umgeleiteten Teil |
Zwei weitere Sicherheitsaspekte aus dem Launch sind wissenswert. Anthropic bezeichnet Fable 5.1 als sein bislang robustestes Modell in einem externen Prompt-Injection-Benchmark – das zählt, wenn ein Agent nicht vertrauenswürdige Webseiten und Dokumente liest. Und für Unternehmen startet ab Herbst 2026 ein Programm namens Enterprise Frontier Safeguards, das Safeguard-Daten und jede menschliche Überprüfung in der eigenen Cloud des Kunden hält – auf AWS, Google Cloud oder Azure – mit einem Datenschutzniveau, das einer Zero-Data-Retention-Richtlinie entspricht.
Wasserzeichen, Anti-Destillation und die EU-KI-Verordnung
Fable 5.1 kommt mit einem unsichtbaren statistischen Wasserzeichen in seinen Textausgaben. Anthropic hat im Juli 2026 zusammen mit 190 weiteren Organisationen den EU-Verhaltenskodex zur Transparenz KI-generierter Inhalte unterzeichnet; das Wasserzeichen ist die Umsetzung dieser Zusage. Es handelt sich um ein statistisches Signal, mit dem ein Erkennungswerkzeug die Wahrscheinlichkeit abschätzen kann, dass Claude an der Erstellung eines Textes beteiligt war. Laut Anthropic hat es „keine praktischen Auswirkungen auf Qualität oder Inhalt der Ausgaben von Claude“ und enthält keine Informationen über den Nutzer, seine Organisation oder das Gespräch. Eine Erkennungs-API befindet sich in einer privaten Vorschau für Regulierungsbehörden, Faktenprüfer, Forschende, Lehrkräfte und Organisationen mit eigenen Prüfpflichten nach der EU-KI-Verordnung (AI Act).
Unabhängig davon hat Anthropic eine verbreitete Technik zur Modell-Destillation unterbunden: Neue API-Konten können frühere Gesprächsrunden nicht mehr manuell bearbeiten und dabei das bisherige Reasoning-Protokoll des Modells behalten. Bestehende Konten sind vorerst nicht betroffen, und Anthropic rechnet damit, dass nur wenige individuelle Integrationen etwas davon bemerken.
Welcher Claude-Tarif enthält Fable 5.1 wirklich?
Hier kommt es aufs Kleingedruckte an. Fable 5.1 ist nicht im Free-Tarif enthalten und in keinem Tarif das Standardmodell – Sie wählen „Fable 5.1“ in der Modellauswahl im Web, auf dem Desktop oder mobil. Wie es abgerechnet wird, hängt vom Tarif ab.
| Tarif | Zugang zu Fable 5.1 | Abrechnung |
|---|---|---|
| Free | Nein | – |
| Pro | Ja | Nutzungsguthaben nach Verbrauch (Pay-as-you-go); Fable-Nutzung läuft außerhalb der normalen Limits des Tarifs |
| Max 5x und Max 20x | Ja, inklusive | Bis zu 50 % Ihrer Wochenlimits ohne Aufpreis; darüber hinaus Nutzungsguthaben oder Modellwechsel |
| Team Standard | Ja | Nutzungsguthaben |
| Team Premium | Ja, inklusive | Bis zu 50 % der Wochenlimits ohne Aufpreis, danach Nutzungsguthaben |
| Enterprise | Ja | In Premium-Seats enthalten; Standard-Seats über Guthaben; nutzungsbasierte Verträge zu API-Preisen |
| Claude API | Ja | Reguläre API-Preise wie oben aufgeführt |
Ein paar praktische Details. In Claude Code setzt Fable 5.1 Version 2.1.250 oder neuer voraus. In Cowork benötigen Sie die aktuelle Claude-Desktop-App. Die Regel „50 % der Wochenlimits“ bei Max und Team Premium ist eine Kapazitätsgrenze, keine Strafe: Sie können die Hälfte Ihres Wochenkontingents für Fable ausgeben und den Rest für Opus oder Sonnet – oder mit Guthaben auf Fable weiterarbeiten. Da mehrere Kunden berichten, dass Fable 5.1 Aufgaben mit weniger Tokens erledigt als Fable 5, reichen diese 50 % womöglich weiter als noch im Juli.
Welcher Tarif ist sinnvoll? Wenn Sie Fable 5.1 täglich nutzen wollen statt nur gelegentlich, spricht die Rechnung für Max. In Pro zehrt jedes Fable-Gespräch an kostenpflichtigem Nutzungsguthaben; in Max ist die Hälfte des Wochenkontingents bereits enthalten. Max 20x ist die Stufe für Claude Code und lange Agentensitzungen – mit der zwanzigfachen Sitzungskapazität von Pro.
Wo Hermanos License ins Spiel kommt
Claude Max 20x Abo. Die Stufe, in der Fable 5.1 inklusive ist, statt nach Verbrauch abgerechnet zu werden – mit vollem Zugang zu Claude Code und Cowork sowie Priorität bei Lastspitzen. Die Verfügbarkeit ändert sich; die Produktseite zeigt aktuellen Bestand, Preis und Lieferdetails, und die Bestellung ist durch unseren 15-tägigen Shop-Support abgedeckt.
Fable 5.1 ist dann am besten, wenn es echte Arbeit vor sich hat – und die meiste davon findet in Software statt, die Sie bereits besitzen oder besitzen sollten. Ein paar Kombinationen, die in der Praxis Sinn ergeben:
| Wenn Sie Fable 5.1 nutzen für … | Passt gut zu | Zu finden unter |
|---|---|---|
| Recherche, Schreiben und Quellenvergleich | Einem zweiten Assistenten zum Gegenprüfen – das Google AI Pro (Gemini) 18-Monats-Abo in unserem Shop enthält zusätzlich 5 TB Google-Speicher | KI-Tools |
| Coding und Claude-Code-Sitzungen | Einem ordnungsgemäß aktivierten Windows-11-Pro-Rechner für die lokale Entwicklung – Pro bietet gegenüber Home zusätzlich Hyper-V, Windows Sandbox, BitLocker und Remote-Desktop-Hosting | Windows 11 |
| Präsentationen, Berichte und Finanzanalysen | Microsoft Office, damit die von Claude erzeugten .pptx- und .xlsx-Dateien exakt so aufgehen wie gedacht | Office-Lizenzen |
| Prozessdiagramme und Projektpläne | Microsoft Visio und Project – Fable 5.1 entwirft, Sie verfeinern | Microsoft Visio & Project |
| Designarbeit und UI-Prototypen | Figma Pro oder CorelDRAW, um Claudes Mock-ups zu fertigen Entwürfen auszuarbeiten | Grafikdesign-Tools |
| Lesen von PDFs, Verträgen und gescannten Dokumenten | Adobe Acrobat Pro zum Bearbeiten und Unterschreiben dessen, was Claude zusammengefasst hat | Adobe Acrobat Pro 2020 |
| Agenten, die für Sie im Web unterwegs sind | Endpoint-Schutz und ein VPN, denn Browsing-Agenten öffnen Seiten, die Sie nie zu Gesicht bekommen | Antivirus- & VPN-Lizenzen |
Alle Lizenzen und Abos bei Hermanos License werden digital geliefert. Claude-Abos unterliegen weiterhin den Verbraucherbedingungen (Consumer Terms) von Anthropic, einschließlich Sitzungs- und Wochenlimits. Wenn Sie unsicher sind, welches Produkt passt, kontaktieren Sie uns vor dem Kauf.
Häufige Fragen
Ist Fable 5.1 ein neues Modell oder ein Update von Fable 5?
Eine neue Version derselben Modellfamilie. Anthropic positioniert es als sein fortschrittlichstes allgemein verfügbares Modell – vor Fable 5 und Opus 5 in jedem veröffentlichten Benchmark, zum gleichen API-Preis und mit niedrigeren effektiven Kosten.
Was ist der Unterschied zwischen Fable 5.1 und Mythos 5.1?
Im zugrunde liegenden Modell keiner. Mythos 5.1 hat schwächere Schutzmechanismen für Cybersicherheit und Biologie und steht nur zugelassenen Organisationen über die Verifizierungsprogramme von Anthropic offen – derzeit nur solchen mit Sitz in den USA. Fable 5.1 ist die Version, die jeder mit einem kostenpflichtigen Tarif nutzen kann.
Kann ich Fable 5.1 im Free-Tarif nutzen?
Nein. Es ist in Pro verfügbar (über Nutzungsguthaben), in Max und Team Premium bis zu 50 % der Wochenlimits inklusive und in Team Standard und Enterprise über Guthaben oder Vertrag. Es ist nie das Standardmodell – wählen Sie es also in der Modellauswahl aus.
Warum ist mein Fable-5.1-Gespräch plötzlich zu Opus gewechselt?
Ein Sicherheitsklassifikator hat die Anfrage dem Bereich offensive Cybersicherheit oder Dual-Use-Biologie zugeordnet. Die Antwort ist mit dem Modell gekennzeichnet, das geantwortet hat, und der umgeleitete Teil wird zu Opus-Preisen abgerechnet. Laut Anthropic kommen diese Eingriffe bei Cyber-Themen rund 60 % seltener vor als bei Fable 5 und bei einfachen Biologiefragen 85 % seltener.
Verändert das Wasserzeichen, was Claude schreibt?
Laut Anthropic nein. Es ist ein statistisches Signal, das ein Erkennungswerkzeug messen kann; für Leser ist es unsichtbar, es enthält keine Informationen über Sie oder Ihr Gespräch und verändert weder Qualität noch Inhalt.
Quellen
Anthropic, Introducing Claude Fable 5.1 and Claude Mythos 5.1 (Ankündigung vom 1. September 2026) · Anthropic, Produktseite zu Claude Fable · Anthropic, Modellübersicht in der Dokumentation (Kontextfenster, Ausgabelimits, Preise) · Anthropic Help Center, Claude Fable models on your plan · Anthropic Help Center, Why Claude switched models in your conversation · Anthropic, Redeploying Claude Fable 5 (Juli 2026). Benchmark-Werte und Kundenzitate sind die von Anthropic veröffentlichten Zahlen; wir haben sie nicht unabhängig überprüft.