Claude Fable 5.1とは?新機能・料金・対応プランを数字で解説
2026年9月1日、Anthropicは6月に投入したFable 5の後継となるClaude Fable 5.1を公開しました。フロンティアモデルの新版としては珍しく、今回の要点は「定価は据え置き、長時間のツール利用を伴う作業は数字に表れるほど向上、そしてFable 5の一部ユーザーを悩ませてきた安全フィルターの作動頻度は大幅に低下」というものです。発表にはもう一つの名前、Claude Mythos 5.1も登場します。こちらは同じモデルからガードレールを減らしたもので、審査を通過した組織にのみ提供されます。
本記事では、Anthropicが公表した数値をもとに、実際に何が変わったのか、API経由での料金はいくらか、どのClaudeサブスクリプションプランで利用できるのか、そしてすでにお使いのツールとどう組み合わせられるのかを解説します。宣伝文句は省き、数字を中心にまとめました。
一目でわかるFable 5.1
| 項目 | Claude Fable 5.1 |
|---|---|
| 公開日 | 2026年9月1日 |
| APIモデルID | claude-fable-5-1 |
| コンテキストウィンドウ/最大出力 | 100万トークン/12万8000トークン |
| 信頼できる知識カットオフ | 2026年6月 |
| エフォートレベル | Low・Medium・High・X-High・Max |
| API定価 | 100万トークンあたり、入力10ドル・出力50ドル・キャッシュ読み取り0.25ドル |
| Claudeプラン | MaxとTeam Premiumに含まれる(週間上限の50%まで)。ProとTeam Standardでは利用クレジット。Freeでは利用不可 |
| 利用できる環境 | Claude.ai、Claude Code、Claude Cowork、Claude API、Amazon Bedrock、Google Vertex AI、Microsoft Foundry |
| 姉妹モデル | Claude Mythos 5.1(重みは同一。セーフガードを軽くし、トラステッドアクセス対象の組織に限定。現時点では米国の組織のみ) |
まずは系譜から:Fable、Mythos、Opus
Anthropicの命名は分かりにくいので、少し整理しておきましょう。長年、同社のラインアップはHaiku、Sonnet、Opusの小・中・大という三段構えでした。2026年にはOpusの上位に新たな階層が加わり、AnthropicはこれをMythosクラスと呼んでいます。フル性能版のMythosは、サイバーセキュリティと生物学の分野での能力が一般公開にはセンシティブすぎると判断されているため、トラステッドアクセスプログラムを通じて承認された組織にしか提供されません。Fableはその同じモデルを分類器ベースのセーフガード(安全フィルター)で包み、誰にでも販売できるようにしたものです。
両者は「よく似た」モデルではありません。AnthropicはFable 5.1とMythos 5.1が同一のモデルであり、違いはセーフガードの強さだけだと明言しています。Fableへのリクエストがセーフガードに触れると、処理はOpusモデルに引き渡されます。セキュリティツールに関わるタスクでFableの公表ベンチマークスコアがMythosよりわずかに低いのはそのためです。詳しくは後述します。
| モデル | 利用できる対象 | 主な用途 | API料金(入力/出力、1Mトークンあたり) |
|---|---|---|---|
| Claude Mythos 5.1 | Anthropicのトラステッドアクセスプログラムで承認された組織。提供開始時点では米国拠点の組織のみ | 防御目的のセキュリティ研究、専門的なライフサイエンス研究開発 | 10ドル / 50ドル |
| Claude Fable 5.1 | Claudeの有料プランまたはAPIの利用者すべて | 最難関のコーディング・調査・ナレッジワーク、長時間の無人エージェント実行 | 10ドル / 50ドル |
| Claude Opus 5 | 全有料プランとAPI | 汎用性の高い主力モデル。Fableのセーフガードが振り分ける生物学系リクエストの受け皿でもある(サイバー系の振り分け先はOpus 4.8) | 5ドル / 25ドル |
| Claude Sonnet 5 | Claudeの各プランとAPIで広く利用可能 | 日常用途の高速アシスタント、大量処理の自動化 | 2ドル / 10ドル |
Fable 5.1の新機能
トークンあたりの性能を高める「エフォートダイヤル」
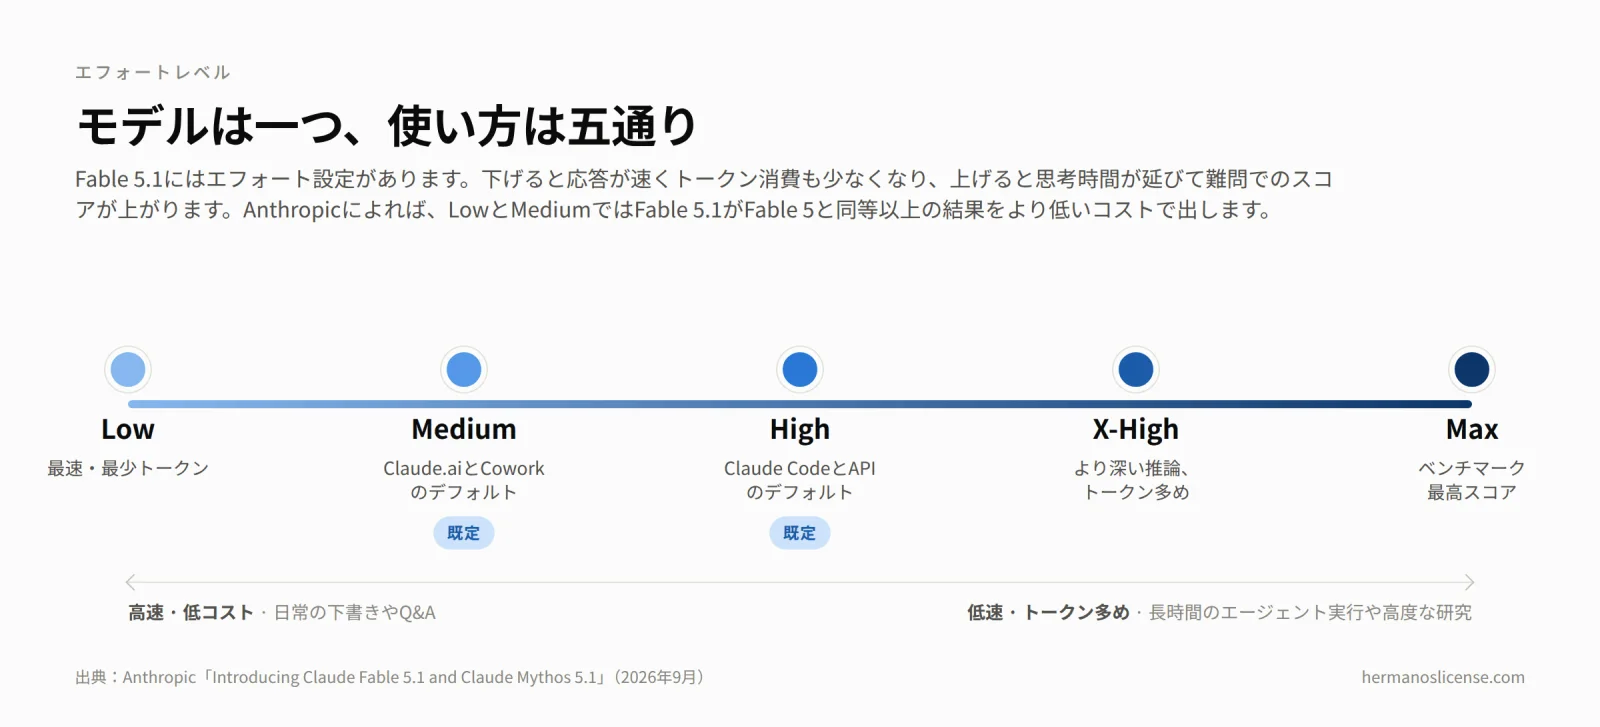
実務上もっとも大きな変化は、個々のベンチマークではなく、モデルが計算資源をどう使うかにあります。Fable 5.1には五段階のエフォートレベル(推論の深さ設定)が用意されています。LowとMediumでは、新モデルは「Fable 5と同等かそれ以上の結果」をはるかに低いコストで達成するとAnthropicは説明しており、日常利用でのコスト削減の大半はここから生まれます。High、X-High、Maxでは思考時間を長く取り、難問で前世代を明確に引き離します。
通常の利用でこの設定に触れる必要はありません。Claude.aiとClaude CoworkではMedium、Claude CodeとAPIではHighがデフォルトです。開発者やパワーユーザーは、大規模なリファクタリングや調査タスクではダイヤルを上げ、下書きや簡単な質問では下げる、といった使い分けができます。
ベンチマークの全体像
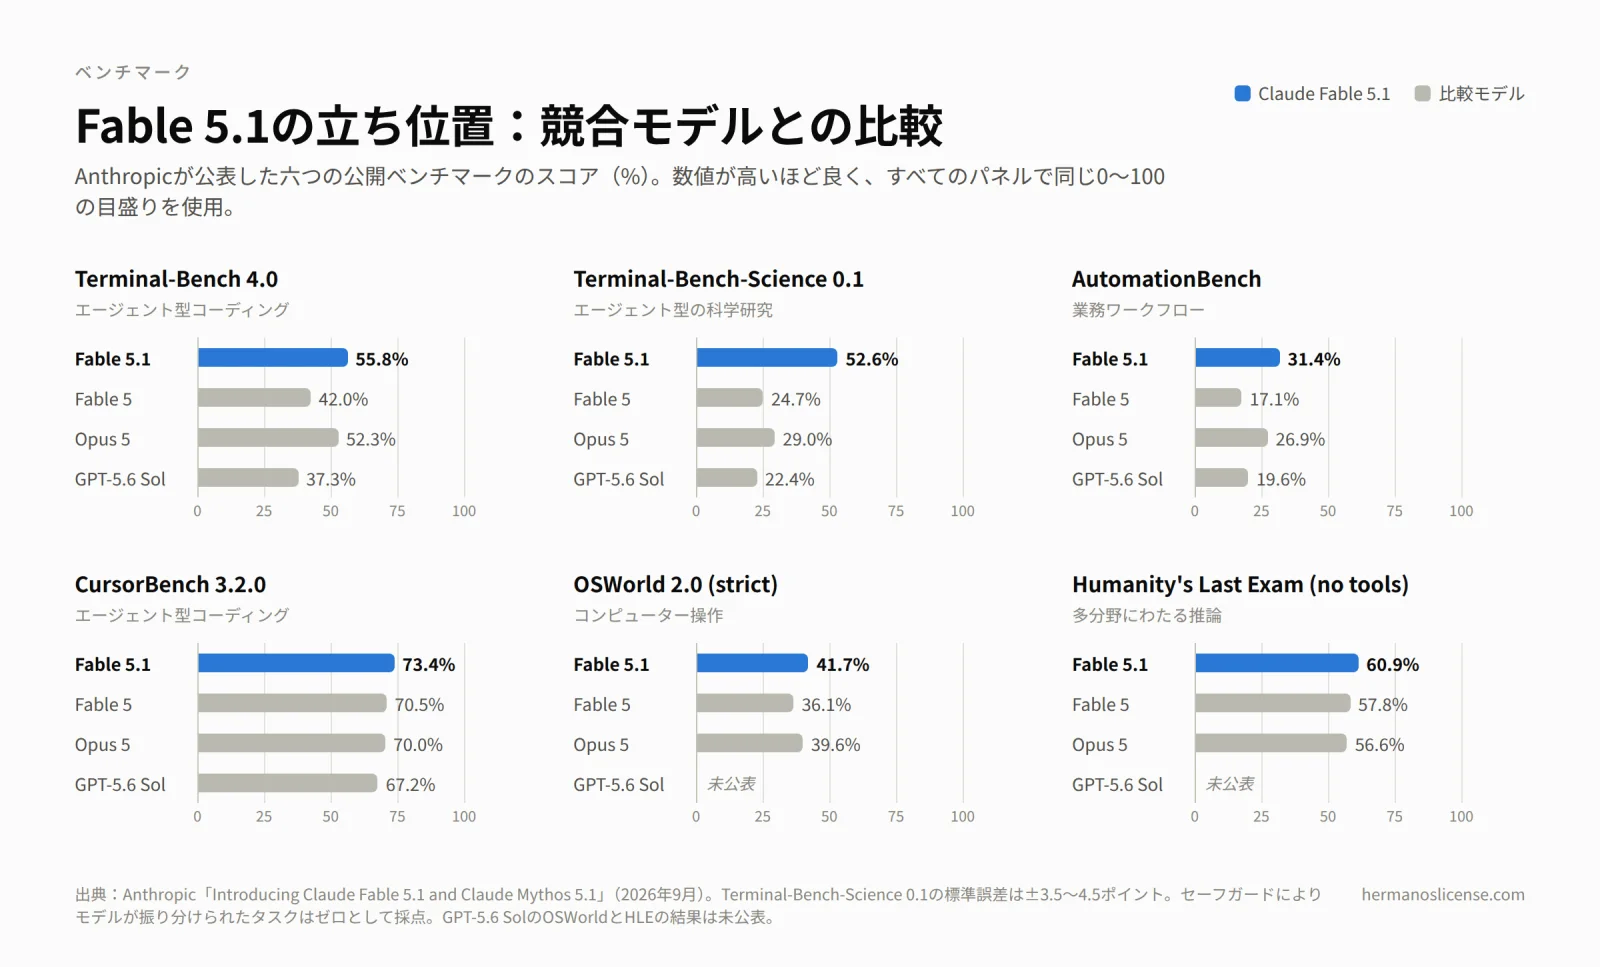
AnthropicはFable 5、Opus 5、OpenAIのGPT-5.6 Solとの比較結果を公表しています。伸びが最も大きいのは、一問一答型の回答ではなく、ターミナルやブラウザーでの持続的な多段階作業を評価するベンチマークです。エージェント型の科学研究を測るTerminal-Bench-Scienceでは、Fable 5.1のスコアはFable 5の倍以上に達しました。業務ワークフローを模したAutomationBenchでもほぼ倍増しています。Humanity's Last Examのような純粋な推論テストでの伸びは確かにあるものの、それより小幅です。
| ベンチマーク | 測定対象 | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | エージェント型コーディング | 55.8% | 42.0% | 52.3% | 37.3% |
| Terminal-Bench-Science 0.1 | エージェント型の科学研究 | 52.6% | 24.7% | 29.0% | 22.4% |
| CursorBench 3.2.0 | エージェント型コーディング(エフォートMax) | 73.4% | 70.5% | 70.0% | 67.2% |
| AutomationBench | 業務ワークフロー | 31.4% | 17.1% | 26.9% | 19.6% |
| OSWorld 2.0(厳格採点) | コンピューター操作 | 41.7% | 36.1% | 39.6% | – |
| OSWorld 2.0(部分点あり) | コンピューター操作 | 77.9% | 72.9% | 75.4% | – |
| Humanity's Last Exam(ツールなし) | 多分野にわたる推論 | 60.9% | 57.8% | 56.6% | – |
| Humanity's Last Exam(ツールあり) | 多分野にわたる推論 | 65.0% | 63.8% | 63.6% | – |
| GDPval-AA v2 | ナレッジワーク(%ではなくレーティング) | 1853 | 1723 | 1824 | 1711 |
出典:Anthropicの発表資料(2026年9月)。Terminal-Bench-Science 0.1の標準誤差はおよそ±3.5〜4.5ポイントあるため、小さな差の解釈には注意が必要です。またAnthropicによれば、セーフガードによってOpusに振り分けられたタスクのスコアはゼロとして扱われており、その分Fableの数値はMythos 5.1より若干低く出ています(Terminal-Bench 4.0ではMythosの60.9%に対し、Fableは55.8%)。
数分ではなく数時間単位の作業のために
ベンチマークはさておき、Anthropicが紹介する顧客の声に共通するテーマは「持久力」です。MongoDBは、検証ループを組み込んだうえでモデルを数時間放置し、目を覚ますと次のフェーズが終わっていた、複雑なプロトタイプを三日間で完成させた、と語っています。Rampは38時間に及ぶ無人の機械学習実行を報告しており、その中でモデルは過去の結果がラベリングのアーティファクトだったと診断し、六つの実験を並行して立ち上げ、結果と次のステップを持ち帰ったといいます。Browserbaseが最難関のブラウザーエージェントタスク(それぞれ10分前後を要するもの)の完了率を計測したところ、Fable 5.1は82%で、Opus 5の74%、Fable 5の57%を上回り、しかも消費トークンは少なかったといいます。
Shopifyのエンジニアは質的な違いを的確に表現しています。自分で記録を取り、優先順位を付け直し、方向を見失わずに中断したところから再開できるモデルだ、と。Anthropicが5.1で本当に売り込もうとしているのはこの能力です。より賢いチャットボットではなく、数時間がかりの仕事を任せられるエージェントなのです。とりわけClaude Codeのユーザーにとっては重要で、そこではデフォルトのエフォートがすでにHighであり、モデルがコードベースを自力で処理していくことが期待されています。
文章作成、リサーチ、日常のナレッジワーク
購入者の全員が開発者というわけではありませんし、5.1の進化はコードに限られません。Gleanは、リサーチ、下書き、目的の明確な質問といった日常的なナレッジワークでブラインド比較を行い、評価者はFable 5.1の回答を二対一の割合でFable 5より好んだと報告しています。Canvaによれば、文章はより分かりやすく意味のあるものになり、指示への追従性も高まり、ブラインドテストでFable 5を上回りました。金融文書を扱うユーザーを抱えるHebbiaは、生成されるPowerPoint資料が試したどのモデルよりも優れており、引用における事実の想起も最も正確だったとしています。実務タスクを第三者機関が評価するGDPval-AA v2では、Fable 5.1が1853、Fable 5が1723というスコアでした。
研究用途の一端
Anthropicは今回の発表で、未解決の科学的問題にモデルを向けると何が起きるかも示しました。特に目を引く例が三つあります。タンパク質バインダーの設計では、通常10〜15%とされる成功率に対し「12種類のターゲットで50%近く」を達成し、三つのターゲットでは競合の最良エントリーの約十倍の親和性を持つバインダーを生み出しました。三十年前のNASAマゼラン探査機のレーダーデータからは、金星の三分の一をカバーする解像度2〜3kmの標高マップを作成しました(従来の地図は10〜20kmが限界でした)。この地図はクリエイティブ・コモンズライセンスで公開されています。さらに、七つのオープンソースのタンパク質・ゲノミクスモデルのGPUカーネルを書き直し、NVIDIA H100上で1.4〜2.5倍に高速化しました。Anthropicによれば、通常なら数週間かかるこの作業は数日で終わったといいます。
なお、こうした高度な生物学の作業はLife Sciences Verification Program(ライフサイエンス検証プログラム)を通じたMythos相当のアクセス権で行われたものであり、生物学系のセーフガードを維持している一般向けのFable 5.1で行われたものではない点に注意してください。
料金:変わった点と変わらなかった点
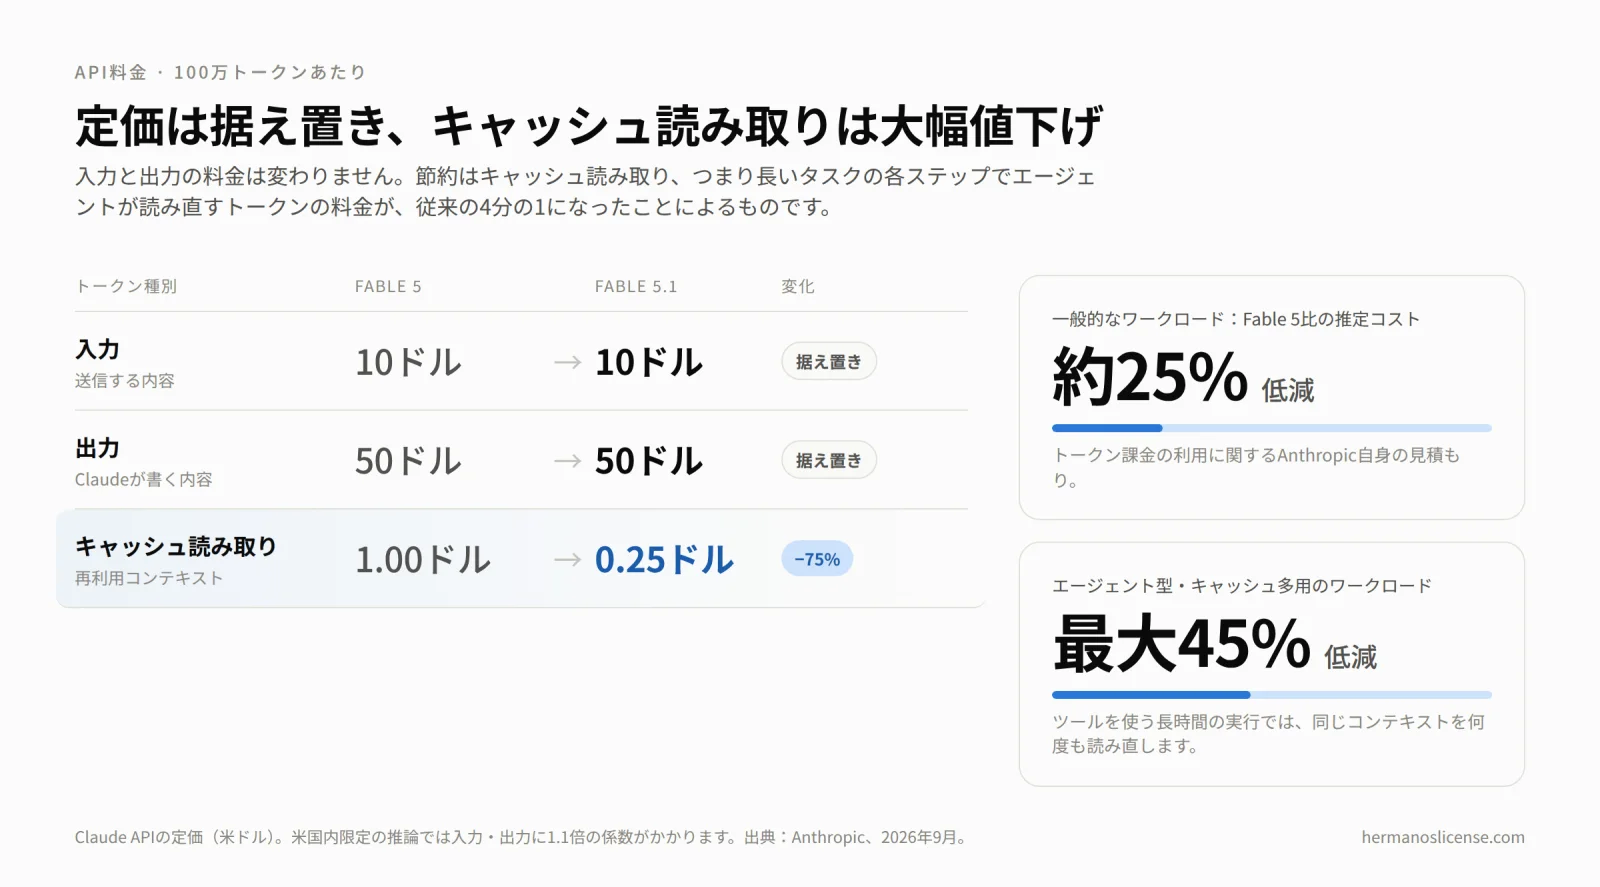
API経由のFable 5.1のトークン単価は、Fable 5とまったく同じです。100万トークンあたり入力10ドル、出力50ドル。変わったのはキャッシュ読み取りで、100万トークンあたり1.00ドルから0.25ドルへと75%引き下げられました。
この用語になじみがない方のために補足すると、Claudeは長いタスクに取り組む際、同じ指示、ファイル、会話履歴をステップごとに読み直します。プロンプトキャッシュは、この繰り返し使われるコンテキストをAPI側に保存し、通常の入力料金ではなく割安な「キャッシュ読み取り」料金を適用する仕組みです。数百ステップに及ぶエージェントでは、請求額の大半をキャッシュ済みトークンが占めます。定価が据え置きでも、Anthropicが一般的なワークロードでFable 5.1の実効コストをFable 5より約25%低く、エージェント色の強いワークロードでは最大45%低く見積もっているのはこのためです。加えて、5.1はより少ないトークンでタスクを終えるため、それだけで追加の節約になったと報告する顧客も複数います。EveryはOpus 5の半分のトークン数で倍の速度を実現したとし、Rogoは自社の金融ベンチマークでFable 5と同等の精度を20%少ないトークンで達成したとしています。
| 1Mトークンあたり | Fable 5 | Fable 5.1 | Opus 5 | Sonnet 5 |
|---|---|---|---|---|
| 入力 | 10.00ドル | 10.00ドル | 5.00ドル | 2.00ドル |
| 出力 | 50.00ドル | 50.00ドル | 25.00ドル | 10.00ドル |
| キャッシュ読み取り | 1.00ドル | 0.25ドル | 最新のAPI料金表を参照 | |
| Fable 5比の推定コスト(一般的なワークロード) | – | 約25%低い | – | |
| Fable 5比の推定コスト(エージェント色の強いワークロード) | – | 最大45%低い | – | |
API定価は米ドル建てで、Anthropicのモデルドキュメントと発表資料に基づきます。米国内限定の推論(US-only inference)では入力・出力に1.1倍の係数がかかります。サブスクリプションプラン(Pro、Max、Team)はトークン単位ではなく月額課金です。詳しくは後述のプランの節をご覧ください。
セーフガード:誤検知は減少、レッドラインは不変
Fable 5のユーザーが最も気にするのはこの部分でしょう。Fable 5の6月の提供開始は波乱含みでした。セーフガードを回避する手法が報告されたことを受けた米政府の指示により、6月12日にアクセスが停止され、規制が解除された7月1日に、より強力な分類器を伴って復旧したのです。この分類器はモデルの安全を保ちましたが、開発者が自分のコードの脆弱性について尋ねたり、一般の人が基本的な生物学や医療の質問をしたりといった正当な作業まで中断させていました。
Fable 5.1もこの仕組み自体は変えていません。分類器が各リクエストを監視し、フラグが立ったものはOpusモデルに引き渡され、返答にその旨の通知が付きます。ただし分類器の精度は大幅に向上しました。Anthropicによれば、セッションあたりのサイバー系セーフガードの介入はFable 5より約60%減少し、初歩的な生物学・医療の質問に対する誤検知は85%減少しました。Claude Codeのユーザーも、サイバーセキュリティ関連の誤検知が同じく60%減っています。実務面での変更点を一つ挙げると、Fable 5.1はコード内のソフトウェアの脆弱性を特定できるようになりました。開発者にとっては日常的な作業です。一方、エクスプロイトの生成、ペネトレーションテスト、バイナリの脆弱性スキャンは引き続きOpusに振り分けられます。
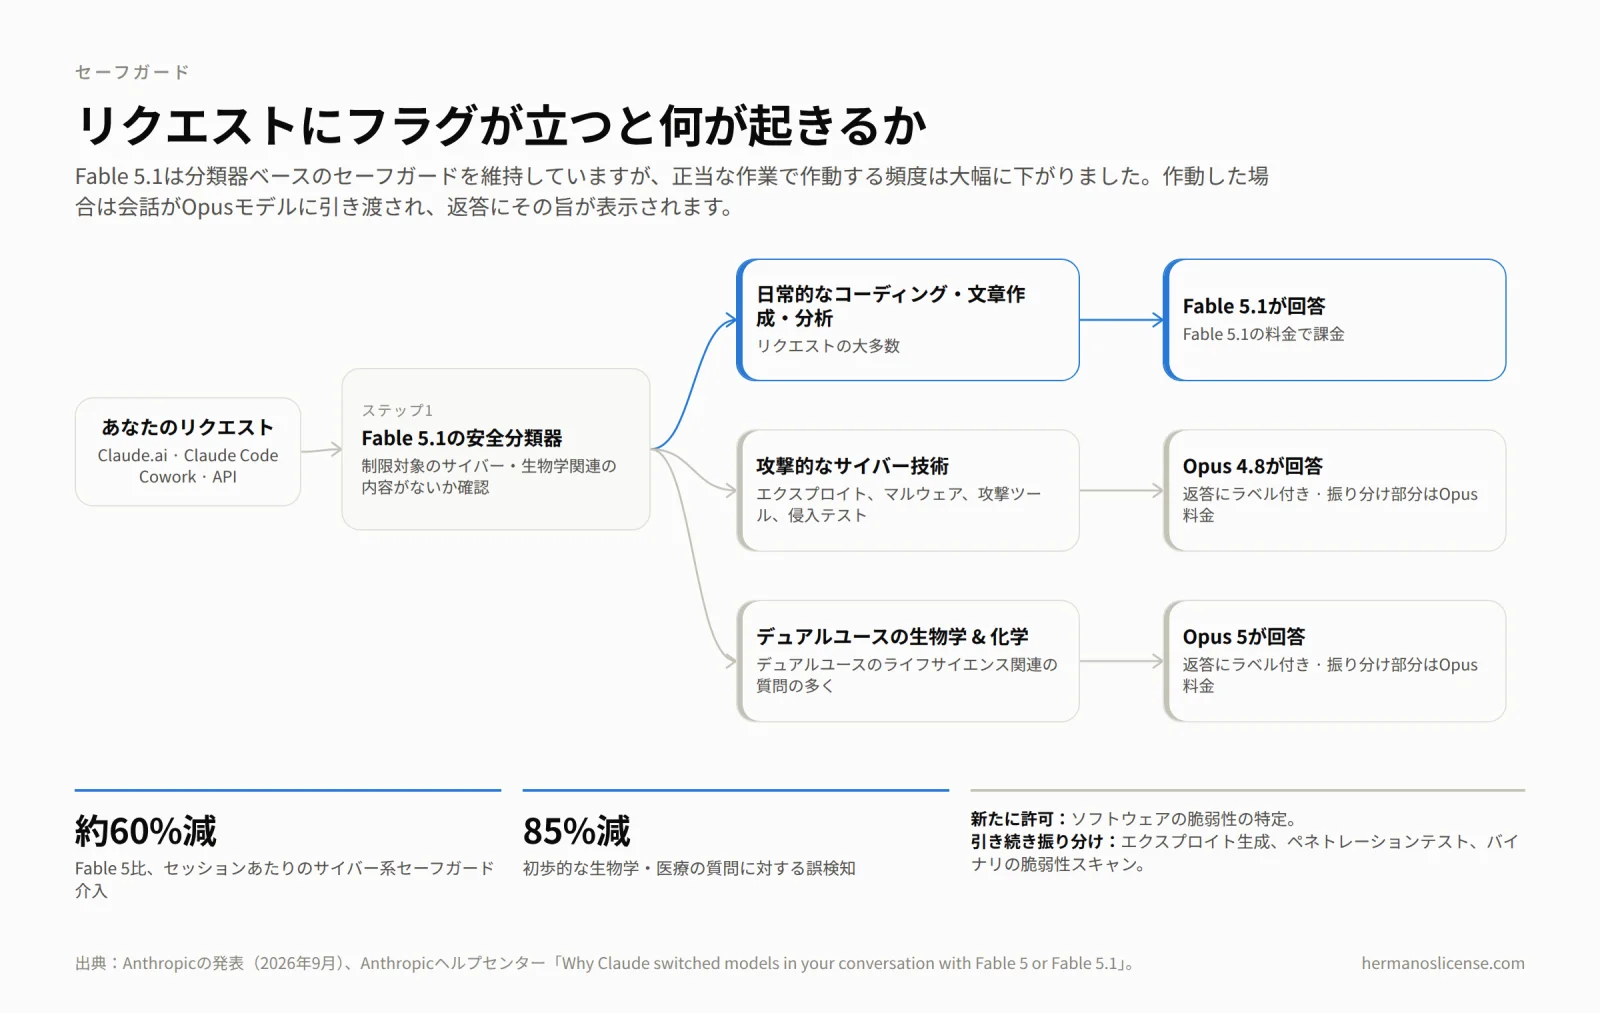
| リクエストの内容 | 回答するモデル | 表示される内容 | 課金の扱い |
|---|---|---|---|
| 日常的なコーディング、文章作成、分析、リサーチ(大多数がこれに該当) | Fable 5.1 | 通常の返答 | Fable 5.1の料金/プランの利用枠 |
| 攻撃的なサイバー技術(エクスプロイト、マルウェア、攻撃ツール) | Opus 4.8 | モデルが切り替わった旨の通知。返答にラベル付き | 振り分けられた部分はOpus料金(生成開始前にブロックされた場合はOpus料金のみ) |
| デュアルユースの生物学・化学・ライフサイエンス関連のリクエスト | Opus 5 | モデルが切り替わった旨の通知。返答にラベル付き | 振り分けられた部分はOpus料金 |
今回の発表で安全面についてほかに押さえておきたい点が二つあります。Anthropicによれば、Fable 5.1は外部のプロンプトインジェクション・ベンチマークにおいて同社史上最も堅牢なモデルであり、これはエージェントが信頼できないWebページや文書を読む場面で重要になります。また企業向けには、Enterprise Frontier Safeguards(エンタープライズ向けフロンティアセーフガード)というプログラムが2026年秋から順次展開されます。セーフガード関連のデータと人手によるレビューを顧客自身のクラウド(AWS、Google Cloud、Azure)内にとどめるもので、データ保持ゼロ(ゼロデータリテンション)ポリシーと同等のプライバシーが確保されます。
電子透かし、蒸留対策、EU AI法
Fable 5.1のテキスト出力には、目に見えない統計的な電子透かしが組み込まれています。Anthropicは2026年7月、ほかの190の組織とともにEUの「AI生成コンテンツの透明性に関する行動規範」に署名しており、今回の電子透かしはその実装にあたります。この透かしは統計的な信号で、検出ツールがテキストの生成にClaudeが関与した可能性を推定できるようにするものです。Anthropicは「Claudeの出力の品質や内容に実質的な影響はない」とし、ユーザーや所属組織、会話に関する情報は一切含まれないと説明しています。検出APIは、規制当局、ファクトチェッカー、研究者、教育関係者、そして同法のもとで独自の検証義務を負う組織向けに、プライベートプレビューとして提供されています。
これとは別に、Anthropicはモデル蒸留でよく使われる手法を一つ封じました。新規のAPIアカウントでは、モデルの過去の推論トランスクリプトを保持したまま会話の以前のターンを手動で編集することができなくなりました。既存のアカウントは当面影響を受けず、影響が出るのはごく一部のカスタム統合にとどまるとAnthropicは見込んでいます。
Fable 5.1が実際に使えるClaudeプランはどれか
ここは細かい条件が重要になります。Fable 5.1はFreeプランでは利用できず、どのプランでもデフォルトのモデルではありません。Web、デスクトップ、モバイルのいずれでも、モデル選択メニューから「Fable 5.1」を選ぶ必要があります。課金の仕方はプランによって異なります。
| プラン | Fable 5.1の利用 | 課金方法 |
|---|---|---|
| Free | 不可 | – |
| Pro | 可 | 従量制の利用クレジット。Fableの利用はプランの通常の上限とは別枠 |
| Max 5xとMax 20x | 可(プランに含まれる) | 週間利用上限の50%まで追加料金なし。それ以降は利用クレジットを使うか、モデルを切り替える |
| Team Standard | 可 | 利用クレジット |
| Team Premium | 可(プランに含まれる) | 週間上限の50%まで追加料金なし、以降は利用クレジット |
| Enterprise | 可 | Premiumシートには含まれる。Standardシートはクレジット経由。従量契約はAPI料金 |
| Claude API | 可 | 上記の標準API料金 |
実務上の細かい点をいくつか。Claude CodeでFable 5.1を使うにはバージョン2.1.250以降が必要です。Coworkでは最新のClaude Desktopが必要になります。MaxとTeam Premiumの「週間上限の50%まで」というルールはペナルティではなく、容量を確保するためのガードレールです。週の利用枠の半分をFableに、残りをOpusやSonnetに使うこともできますし、クレジットを使ってFableを使い続けることもできます。Fable 5.1はFable 5より少ないトークンでタスクを終えるという報告が複数の顧客から出ているため、この50%の枠は7月時点よりも実質的に長持ちするかもしれません。
どのプランを選ぶべきか。Fable 5.1をたまの贅沢ではなく日常の主力として使いたいなら、計算上はMaxが有利です。Proでは、Fableとの会話のたびに有料の利用クレジットを消費しますが、Maxでは週間利用枠の半分があらかじめ含まれています。Max 20xはClaude Codeや長時間のエージェントセッション向けに設計された階層で、セッション容量はProの20倍です。
Hermanos Licenseでそろえられるもの
Claude Max 20x サブスクリプション。Fable 5.1が従量課金ではなくプランに含まれる階層で、Claude CodeとCoworkをフルに利用でき、アクセス集中時にも優先されます。在庫状況は変動します。最新の在庫、価格、納品方法は商品ページでご確認ください。ご注文は当店の15日間ストアサポートの対象です。
Fable 5.1が真価を発揮するのは、目の前に実際の仕事があるときです。そしてその仕事の多くは、すでにお持ちの(あるいは持っておくべき)ソフトウェアの中で行われます。実用的な組み合わせをいくつか挙げます。
| Fable 5.1の用途 | 相性のよい組み合わせ | 取り扱いカテゴリー |
|---|---|---|
| リサーチ、文章作成、情報源の比較 | クロスチェック用の第二のアシスタント。当店のGoogle AI Pro(Gemini)18か月プランには5TBのGoogleストレージも付属 | AIツール |
| コーディングとClaude Codeのセッション | ローカル開発用に正規認証済みのWindows 11 Proマシン。ProにはHomeにないHyper-V、Windows Sandbox、BitLocker、リモートデスクトップのホスト機能が備わる | Windows 11 |
| プレゼン資料、レポート、財務分析 | Microsoft Office。Claudeが生成する.pptxや.xlsxファイルを意図どおりに開ける | Office ライセンス |
| 業務フロー図とプロジェクト計画 | Microsoft VisioとProject。Fable 5.1が下書きし、人が仕上げる | Microsoft Visio・Project |
| デザイン作業とUIプロトタイプ | Claudeのモックアップを完成品に仕上げるためのFigma ProまたはCorelDRAW | グラフィックデザインツール |
| PDF、契約書、スキャン文書の読み取り | Claudeが要約した文書を編集・署名するためのAdobe Acrobat Pro | Adobe Acrobat Pro 2020 |
| ユーザーに代わってWebを閲覧するエージェント | エンドポイント保護とVPN。閲覧エージェントはユーザーの目に触れないページも開くため | アンチウイルス・VPN ライセンス |
Hermanos Licenseで取り扱うライセンスとサブスクリプションはすべてデジタル納品です。ClaudeのサブスクリプションにはAnthropicの消費者向け利用規約(セッション上限や週間上限を含む)が引き続き適用されます。どの商品が適しているか分からない場合は、ご購入前にお問い合わせください。
よくある質問
Fable 5.1は新モデルですか、それともFable 5のアップデートですか?
同じモデルファミリーの新リリースです。Anthropicは、公表したすべてのベンチマークでFable 5とOpus 5を上回る、一般提供中で最も高度なモデルと位置づけています。API料金は同じで、実効コストは下がっています。
Fable 5.1とMythos 5.1の違いは何ですか?
基盤となるモデルに違いはありません。Mythos 5.1はサイバーセキュリティと生物学に関するセーフガードが軽く、Anthropicの検証プログラムで承認された組織(現時点では米国拠点の組織)にのみ提供されます。Fable 5.1は、有料プランの利用者なら誰でも使えるバージョンです。
FreeプランでFable 5.1は使えますか?
使えません。Proでは利用クレジット経由で利用でき、MaxとTeam Premiumでは週間上限の50%までプランに含まれ、Team StandardとEnterpriseではクレジットまたは契約に基づいて利用できます。デフォルトのモデルになることはないため、モデル選択メニューから選んでください。
Fable 5.1との会話が突然Opusに切り替わったのはなぜですか?
安全分類器が、そのリクエストを攻撃的なサイバーセキュリティまたはデュアルユースの生物学に関わるものと判定したためです。返答には回答したモデルのラベルが付き、振り分けられた部分はOpus料金で課金されます。Anthropicによれば、こうした介入はFable 5と比べてサイバー系の話題で約60%、基本的な生物学の質問で85%減っています。
電子透かしはClaudeの書く内容を変えますか?
Anthropicによれば、変えません。検出ツールが測定できる統計的な信号であり、読み手には見えず、ユーザーや会話に関する情報は含まれず、品質や内容も変わりません。
出典
Anthropic「Introducing Claude Fable 5.1 and Claude Mythos 5.1」(発表記事、2026年9月1日)· Anthropic「Claude Fable製品ページ」· Anthropic「Models overview」(モデル一覧:コンテキストウィンドウ、出力上限、料金)· Anthropicヘルプセンター「Claude Fable models on your plan」(各プランでのFableモデルの利用条件)· Anthropicヘルプセンター「Why Claude switched models in your conversation」(会話の途中でモデルが切り替わる理由)· Anthropic「Redeploying Claude Fable 5」(2026年7月)。 ベンチマークの数値と顧客のコメントはいずれもAnthropicが公表したものであり、当サイトで独自に検証したものではありません。